총정리 및 어려웠던 부분
앞서 ‘Attention Is All You Need’ 논문 리뷰를 진행했는데, 해당 글만보고 이해하기 쉽지 않을 수 있습니다. 따라서, 해당 논문 내용을 이해하기 쉽게 총정리하고, 제가 읽으며 어려웠던 부분도 따로 정리해볼까 합니다.
1. 기존 모델의 한계와 Transformer의 등장 배경
기존 Sequence Transduction 모델들의 주류는 인코더와 디코더를 포함한 복잡한 RNN이나 CNN 기반이었습니다. 최고 성능을 내는 모델 역시 RNN/CNN에 Attention 메커니즘을 결합한 형태였습니다.
특히 LSTM이나 GRU 같은 순환 모델들은 입력 및 출력 시퀀스의 기호 위치를 따라 순서대로만 계산을 진행해야 하는 ‘순차적 계산(Sequential Nature)’의 한계가 있었습니다. 현재 상태의 벡터를 계산하려면 반드시 그 이전 상태의 벡터가 필요하기 때문입니다. 이러한 구조는 학습 시 연산의 병렬화를 방해하며, 문장의 길이가 길어질수록 메모리 제약이 커지고 연산 효율이 떨어집니다.
이 논문은 순환 구조를 과감히 버리고, 입출력 사이의 전역적 의존성(Global Dependencies)을 오직 Attention에만 의존하여 뽑아내는 Transformer 구조를 최초로 제안했습니다. 이를 통해 병렬화가 가능해졌고 학습 시간을 획기적으로 단축할 수 있었습니다.
2. 모델 아키텍처 (Model Architecture)
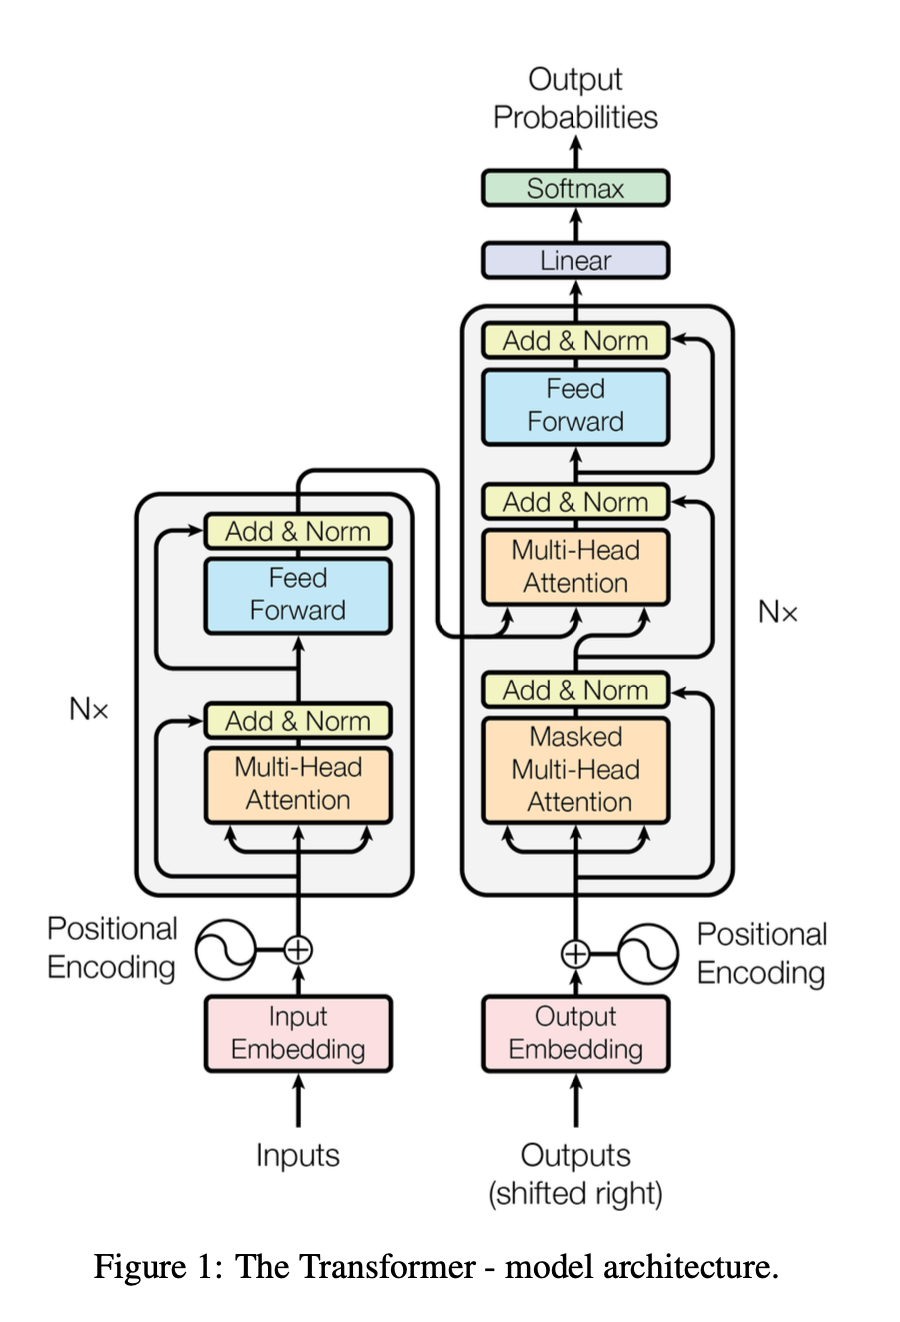
Transformer 역시 거대한 인코더-디코더 구조를 따르되, 내부를 RNN 대신 Self-Attention과 피드포워드 네트워크(Point-wise Feed-Forward Networks)로 채웠습니다.
2.1. 인코더와 디코더 적층 구조
- Encoder: 총 6개의 동일한 레이어를 쌓아 올립니다. 각 레이어는
Multi-Head Self-Attention과Position-wise Feed-Forward Network라는 2개의 서브 레이어를 가집니다. - Decoder: 역시 6개의 레이어를 쌓지만, 인코더의 정보를 받아와야 하므로
디코더-인코더 어텐션이 추가되어 총 3개의 서브 레이어를 가집니다. 또한, 단어를 순서대로 예측할 때 미래의 단어를 미리 커닝하는 것을 막기 위해 ‘마스킹(Masking)’ 기법을 추가했습니다.
⚠️ 아키텍처 디테일: 학습을 안정적으로 돕기 위해 각 서브 레이어 주변에 잔차 연결(Residual Connection)을 도입하고, 레이어 정규화(Layer Normalization)를 거칩니다.
- 출력 형식: $\text{LayerNorm}(x + \text{Sublayer}(x))$
- 잔차 연결을 매끄럽게 더하기 위해 모델 내부의 모든 임베딩 차원과 서브 레이어의 출력 차원은 $d_{model}=512$로 통일했습니다.
3. 핵심 메커니즘: Attention
Attention은 한마디로 “질문(Query)을 식별자(Key)-값(Value) 쌍의 세트와 연관 지어 최적의 정보를 뽑아내는 함수”입니다.
3.1. Scaled Dot-Product Attention
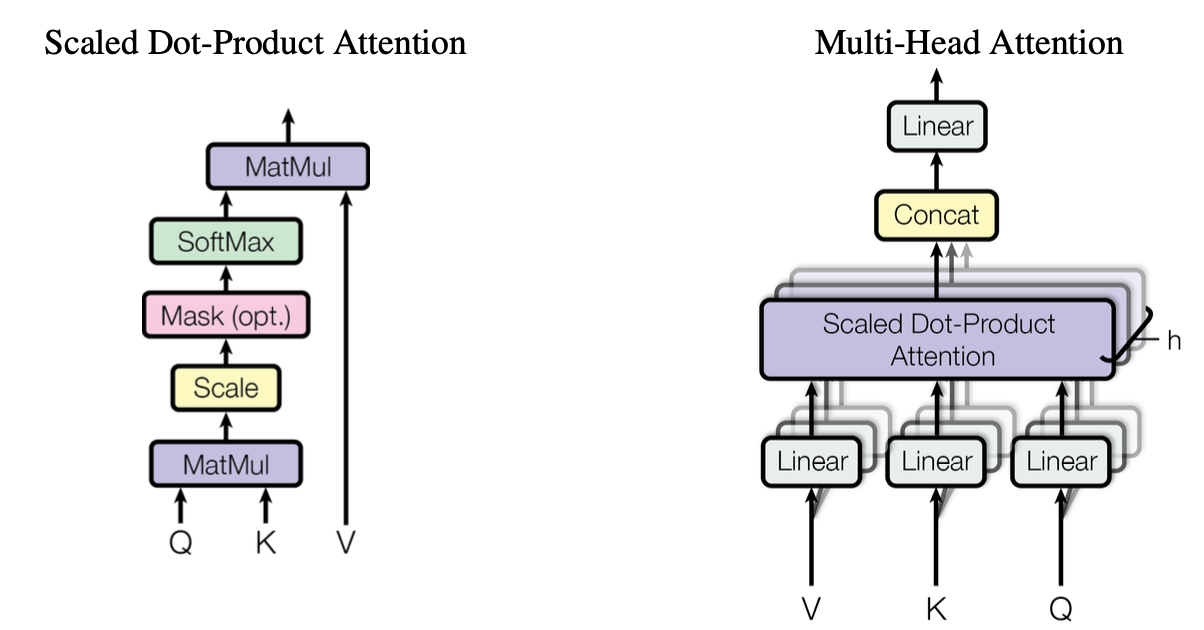
Transformer는 가장 빠르고 공간 효율적인 Dot-Product(내적) 어텐션 방식을 기본으로 사용합니다.
\[\text{Attention}(Q, K, V) = \text{softmax}\left(\frac{QK^T}{\sqrt{d_k}}\right)V\]차원 수($d_k$)가 커지면 내적 값 자체가 너무 커져서, softmax 함수를 통과할 때 기울기가 극도로 작아지는 경사 소실(Gradient Vanishing) 구간에 빠지게 됩니다. 이를 방지하기 위해 차원의 제곱근($\sqrt{d_k}$)으로 값을 나누어 스케일링을 해주는 것이 핵심입니다.
3.2. Multi-Head Attention
512차원의 벡터를 한 번에 연산하는 대신, 서로 다르게 학습된 선형 사영을 통해 작은 차원으로 8번 쪼개서 병렬로 어텐션을 수행합니다.
\[\mathrm{MultiHead}(Q, K, V) = \mathrm{Concat}(\mathrm{head}_1, \dots, \mathrm{head}_h)W^O\]단일 어텐션을 사용하면 문장 전체의 평균적인 정보만 보게 되지만, 헤드(Head)를 여러 개로 쪼개면 다양한 위치에서 서로 다른 서브 스페이스의 정보(예: 주어와 동사 관계, 형용사와 명사 관계 등)에 동시에 집중할 수 있는 장점이 있습니다.
4. Positional Encoding (위치 인코딩)
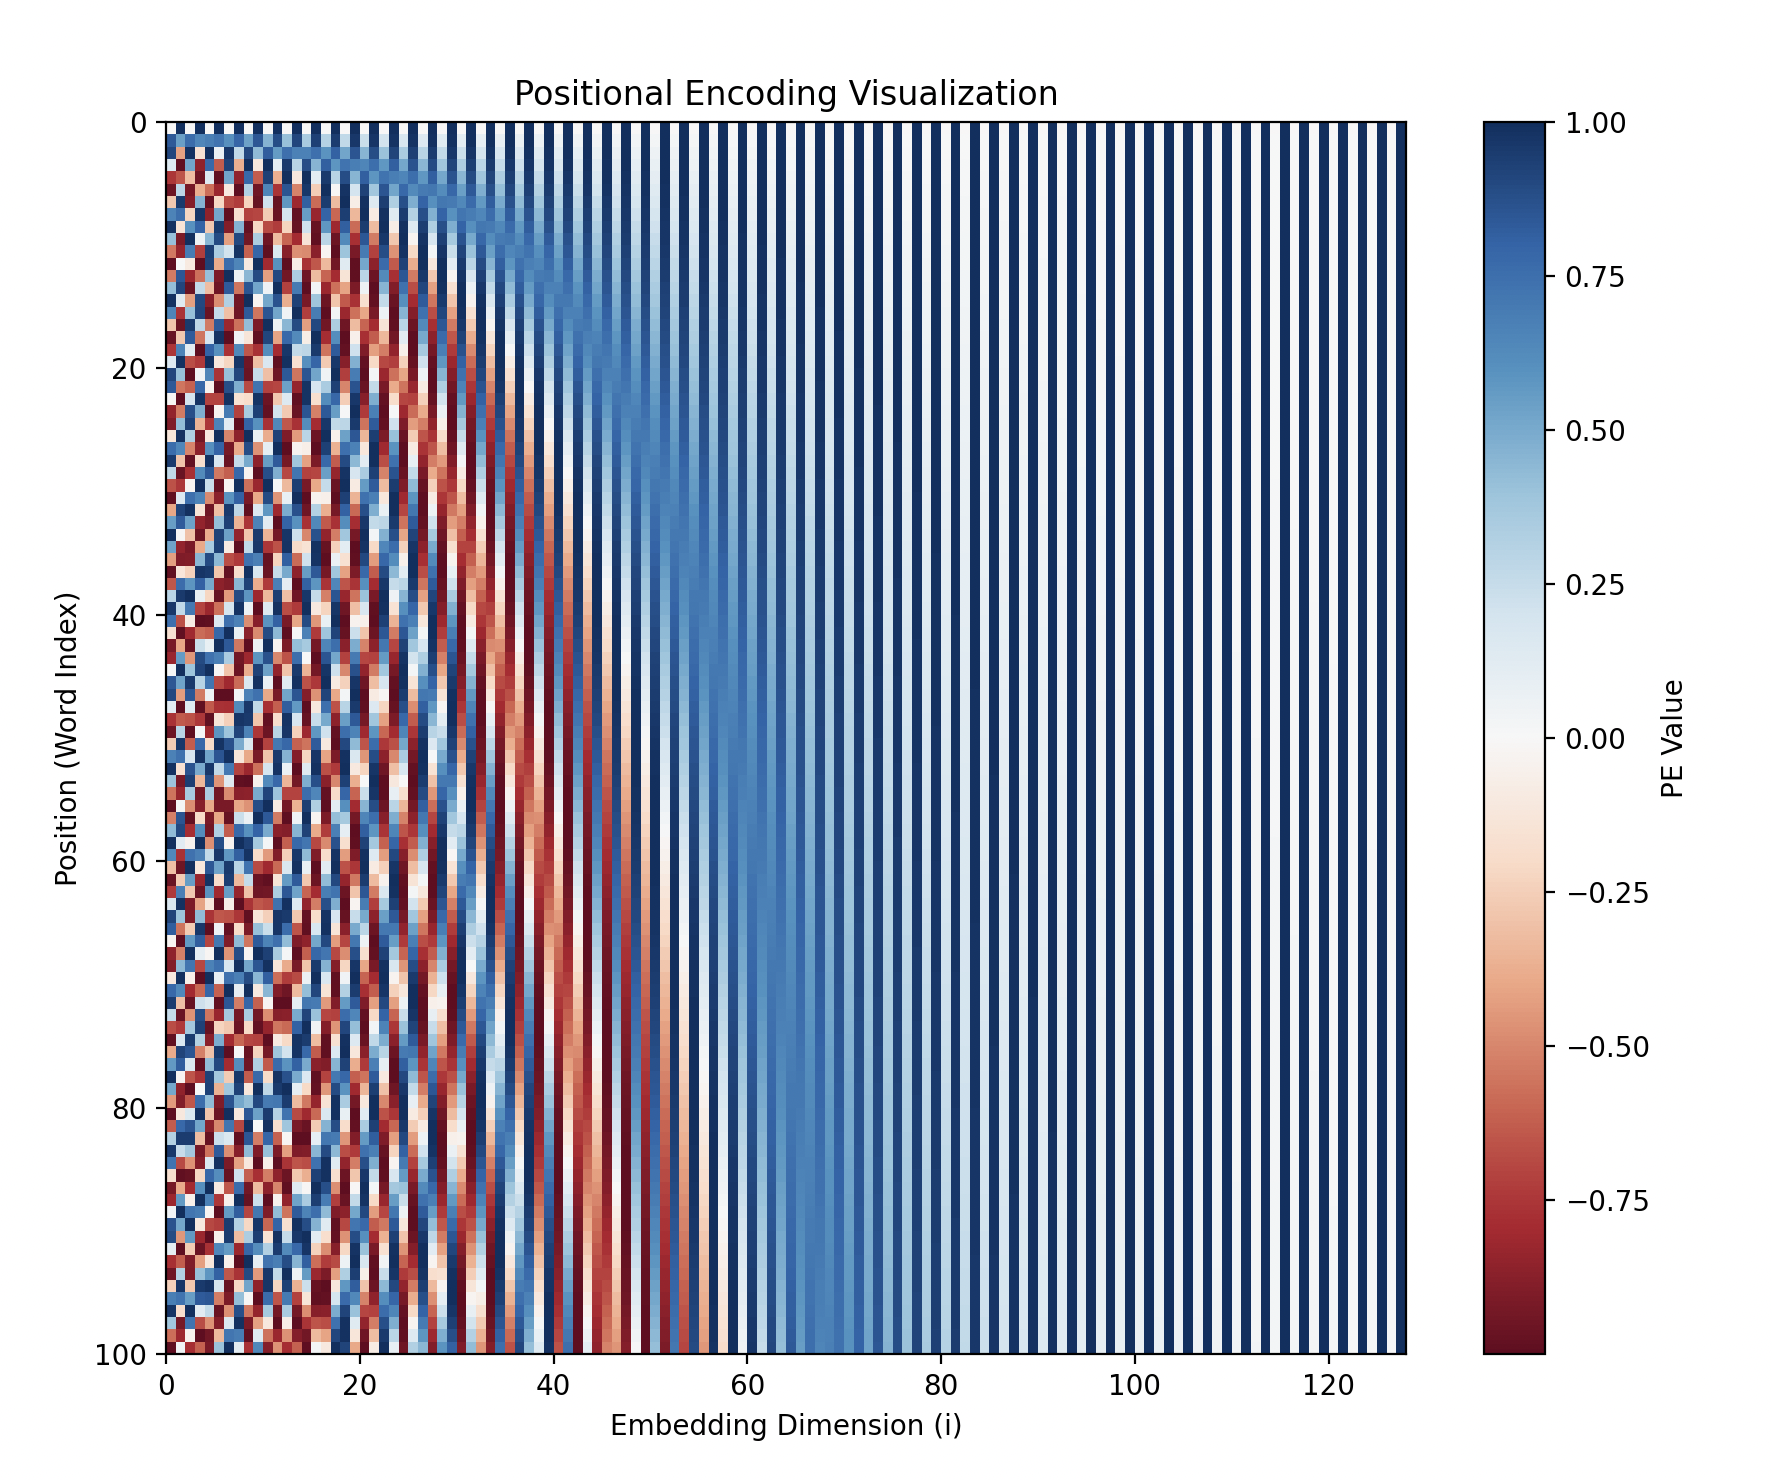
Transformer는 순환 모델이 아니므로 단어의 ‘순서나 위치 정보’가 입력되지 않습니다. 이 문제를 해결하기 위해 시퀀스 내 토큰의 위치 정보를 주입하는 Positional Encoding을 추가합니다.
저자들은 다양한 주기를 가진 $\sin$ 함수와 $\cos$ 함수를 사용했습니다.
\(PE_{(\mathrm{pos}, 2i)} = \sin\left(\frac{\mathrm{pos}}{10000^{2i / d_{\mathrm{model}}}}\right)\) \(PE_{(\mathrm{pos}, 2i+1)} = \cos\left(\frac{\mathrm{pos}}{10000^{2i / d_{\mathrm{model}}}}\right)\)
삼각함수를 활용하면 특정 오프셋($k$)만큼 떨어진 위치의 값을 선형 결합으로 쪼개어 표현할 수 있기 때문에, 모델이 단어들 간의 상대적인 위치 관계를 매우 쉽게 학습할 수 있습니다.
5. Q&A: 논문을 읽으며 어려웠던 개념 정리 👆
개인적으로 논문을 읽으면서 이해하기 까다로웠던 6가지 디테일을 따로 정리해 보았습니다.
1. Positional Encoding과 삼각함수 왜 수많은 함수 중 $\sin$과 $\cos$일까요? 특정 오프셋 $k$에 대해 $PE(pos+k)$가 $PE(pos)$의 선형 결합으로 표현될 수 있기 때문입니다. 즉, $pos+k$ 위치의 값을 $PE(pos) \times M$(고정된 행렬) 구조로 바꿀 수 있어 모델이 상대적인 거리 관계를 쉽게 학습할 수 있습니다.
2. Scaled Dot-Product Attention과 Multi-Head Attention? 어텐션 점수를 낼 때 빠르지만 값이 비대해지는 내적(Dot-Product)의 단점을 $\sqrt{d_k}$로 나누어(Scaling) 해결한 것이 Scaled Dot-Product Attention입니다. 그리고 이 과정을 거대한 단일 연산으로 처리하지 않고, 8개($h=8$)로 쪼개어 병렬 연산함으로써 다양한 문맥적 관점을 동시에 확보하는 것이 Multi-Head Attention입니다.
3. Residual Connection & Layer Normalization? Residual Connection(잔차 연결)은 레이어를 거친 결과물에 거치기 전의 원래 입력값 $x$를 더해주는 장치로, 깊은 층에서도 정보 손실과 경사 소실(Gradient Vanishing)을 막습니다. Layer Normalization은 하나의 문장 샘플 안에서 단어 벡터들의 특징 차원을 기준으로 평균과 분산을 정규화하여 학습을 안정화시킵니다.
4. 왜 인코더, 디코더 레이어수가 N=6? 서브레이어의 구조는 왜 저런지? $N=6$은 실험적으로 연산 속도와 모델 성능(BLEU 점수) 사이에서 찾은 최적의 실용적 타협점입니다. 서브 레이어가 어텐션과 FFN으로 구성된 이유는, 어텐션이 ‘문맥과 의미적 관계를 파악’하면 FFN이 ‘파악된 특징들을 비선형적으로 융합하고 가공’하는 상호보완적 역할을 하기 때문입니다.
5. $d_v$, $d_k$, $d_{model}$ 등의 차원이 어떻게 결정? 잔차 연결을 위해 모델 전체의 기본 차원은 $d_{model}=512$로 고정됩니다. Multi-Head Attention에서 헤드 개수를 $h=8$로 정했으므로, $d_k$와 $d_v$는 $d_{model} / h = 512 / 8 = 64$차원으로 자연스럽게 결정됩니다.
6. 학습 가능한 Embedding을 사용한다는 말이 무슨 말인가? 초기 모델은 ‘사과’라는 단어의 의미를 모르기 때문에 512차원 공간에 무작위로 벡터를 흩뿌립니다. 하지만 수많은 문장을 학습하며 역전파를 거치면, 비슷한 의미를 가진 단어끼리 벡터 공간상에 물리적으로 가깝게 모이도록 벡터 안의 숫자(가중치)들이 점진적으로 업데이트(학습)된다는 뜻입니다.
6. 처음 읽는 독자를 위한 추가 가이드 ✔️
이 논문을 처음 접할 때 많은 분들이 헷갈려하는 두 가지 핵심 개념을 덧붙입니다.
Q, K, V (Query, Key, Value)가 정확히 무엇인가요? 데이터베이스 검색에 비유하면 이해가 쉽습니다. 유튜브에서 영상을 찾는다고 가정해 봅시다.
- Query (질문): 검색창에 내가 입력한 검색어 (예: “머신러닝 기초”)
- Key (식별자): 각 영상들이 가지고 있는 제목이나 태그 (예: “딥러닝 입문”, “AI 수학”)
- Value (값): 그 제목(Key)을 클릭했을 때 나오는 실제 영상 내용
모델은 문장 속 한 단어(Query)가 다른 단어들(Keys)과 얼마나 연관되어 있는지 유사도를 구하고, 그 유사도를 바탕으로 실제 의미(Values)들을 혼합해 문맥을 파악합니다.
디코더의 마스킹(Masking)은 왜 필요한가요? 인코더는 입력된 문장 전체를 한 번에 봅니다. 반면, 디코더는 단어를 하나씩 순서대로 만들어내는 자기회귀적(Auto-regressive) 특성이 있습니다. 우리가 글을 쓸 때 아직 쓰지 않은 미래의 글을 참조할 수 없는 것과 같습니다. 하지만 딥러닝 학습 시에는 정답 문장 전체를 한 번에 연산하므로, 디코더가 미래에 예측해야 할 단어를 미리 보고 학습하는(커닝) 것을 물리적으로 차단하기 위해 마이너스 무한대($-\infty$) 값으로 가려버리는 것이 마스킹입니다.