[논문리뷰] Attention Is All You Need
RNN과 CNN을 완전히 버리고 오직 Self-Attention 메커니즘만으로 최고 성능을 달성한 혁신적인 Transformer 아키텍처 리뷰입니다.
1. Abstract
📌 기존 모델의 한계 제시
그동안 Sequence Transduction(시퀀스 변환) 모델들의 주류는 인코더와 디코더를 포함한 복잡한 RNN이나 CNN 기반 아키텍처였습니다. 당시 최고 성능을 내던 모델들 역시 대개 RNN이나 CNN 구조에 Attention 메커니즘을 결합한 형태를 취하고 있었습니다.
✔️ Transformer의 제안
이 논문에서는 기존의 순환 구조(Recurrent)나 합성곱(Convolution)을 완전히 걷어내고, 오직 Attention 메커니즘만을 기반으로 작동하는 새로운 아키텍처인 Transformer를 제안합니다.
👆 실험적 성과
- 병렬화 및 학습 시간: 순환 구조를 완전히 없앰으로써 연산의 병렬 처리가 가능해졌고, 이로 인해 학습 시간을 획기적으로 단축했습니다.
- 번역 성능 향상: 기존 최고 성능 모델들을 능가하는 번역 퀄리티를 달성했습니다.
- 일반화 능력 확보: 다른 대규모 데이터셋이나 다양한 작업에서도 훌륭한 일반화 능력을 보여주었습니다.
2. Introduction
⚠️ RNN의 고질적인 문제점: 순차적 계산
LSTM이나 GRU 같은 순환 모델들은 입력 및 출력 시퀀스의 Symbol Position(기호 위치)을 따라 한 걸음씩 순차적으로 계산을 진행합니다. 즉, 현재 상태의 은닉 벡터인 $h_t$를 계산하려면, 반드시 바로 직전 상태의 은닉 벡터인 $h_{t-1}$과 현재 위치 $t$의 입력값이 필요합니다.
- 병렬화의 부재와 메모리 제약: 이러한 Sequential Nature(순차적 성격)은 학습 시에 연산의 병렬화를 근본적으로 방해합니다. 문장의 길이가 길어질수록 모든 계산을 동시에 처리할 수 없고 하나씩 밀고 나가야 하므로, Batch 크기가 크게 제한되고 메모리 제약이 극도로 심해집니다.
- 기존 연구들이 연산 효율이나 모델 성능을 높이기 위해 여러 트릭(Factorization 트릭, Conditional Computation 등)을 도입해보았지만, 순차적 계산이라는 구조적 제약은 여전히 해결되지 않은 숙제로 남아있었습니다.
✔️ Attention의 역할과 한계
Attention은 입출력 시퀀스 내의 거리에 상관없이 단어 간의 의존성을 모델링할 수 있게 해주는 핵심 장치로 자리 잡았습니다. 그러나, 여전히 이전 연구에서의 Attention 메커니즘은 RNN과 결합하여 사용되는 한계가 있었습니다.
- Transformer: 해당 논문에서 제시하는 방법론입니다. 순환 구조 (recurrence)를 과감히 버리고, 입출력 사이의 Global Dependency(전역적 의존성)을 오로지 Attention에만 의존하여 뽑아내는 구조를 제안합니다. 이를 통해 병렬화가 가능해지고, 시간적인 효율을 증가시킬 수 있습니다.
✔️ 전역적 의존성 (Global Dependency)이란 무엇인가?
기계번역이나 언어 모델링에서 아주 중요하게 다루어지는 개념이 바로 ‘전역적 의존성’입니다.
💡 말이 멀리 떨어져 있어도 관계를 맺는 현상: ** 예를 들어, “과거에 수많은 실패와 고난, 역경을 겪으며 힘든 시간을 보냈던 **그 청년은, 끊임없는 노력 끝에 마침내 거대한 글로벌 기업의 CEO가 되었다.”라는 문장이 있습니다.
여기서 ‘그 청년은’과 ‘CEO가 되었다’는 문장 내 위치상으로는 매우 멀리 떨어져 있습니다. 하지만 문맥을 정확히 파악하기 위해서는 이 두 단어의 관계를 반드시 하나로 연결 지어야 합니다.
이처럼 문장 전체(Global)를 관통하며 멀리 떨어진 요소들이 서로 의존하고 있는 관계를 전역적 의존성이라고 부릅니다. 이전 연구의 RNN, LSTM, CNN 구조에서는 입력 사이의 거리가 멀어질수록 정보가 소실되거나 희석되는 경사 소실(Gradient Vanishing) 문제 등으로 이를 다루기가 매우 힘들었습니다. Transformer는 바로 이 문제를 완벽하게 극복하기 위해 설계되었습니다.
3. Background
✔️ CNN 기반 모델과의 비교
순차적 계산을 줄이기 위해 CNN을 기본 빌딩 블록으로 삼아 모든 입출력 위치의 은닉 표현을 병렬로 계산하려는 시도(ConvS2S, ByteNet 등)들이 존재했습니다.
하지만 이러한 CNN 기반 모델들은 임의의 두 입출력 위치 사이의 신호를 연관 짓는 데 필요한 연산 수가 두 위치 사이의 거리에 따라 증가한다는 한계가 있습니다.
- ConvS2S: 거리에 따라 선형적(Linear)으로 증가
- ByteNet: 거리에 따라 로그 스케일(Logarithmic)로 증가
결과적으로 두 단어 사이의 거리가 멀어지면 멀어질수록 서로 멀리 떨어진 위치 간의 의존성을 학습하기가 매우 어려워집니다.
👆 Transformer가 보완하는 점
Transformer는 이를 단 상수 번(Constant, $O(1)$)의 연산으로 줄여버립니다.
⚠️ 다만, Attention 가중치가 적용된 위치들을 가중 평균 내는 과정에서 Effective Resolution(유효 해상도)이 다소 감소하는 대가가 따르는데, 논문에서는 뒤이어 소개할 Multi-Head Attention 구조를 통해 이 해상도 감소 문제를 멋지게 해결해 냅니다.
현재까지 내용만 들어도 머리가 복잡할 수 있습니다. 하지만 지금까지, 해당 논문이 이야기하고자 하는 바는 매우 단순합니다.
“기존의 RNN은 문장이 주어지면, 한 글자 한 글자 순서대로 계산해야 해서 너무 느리고 병렬적인 처리가 불가능하다는 단점이 존재했습니다. 따라서, 이전 연구에서는 이를 CNN으로 해결하고자 하였지만, 멀리 떨어진 단어 조합을 잘 매칭(Global Dependency)하지 못한다는 문제가 있었습니다. 따라서, 해당 논문에서는 RNN, CNN 구조를 탈피하고, 오직 단어들끼리 서로의 연관성을 한 번에 파악하는 ‘Self-Attention’만으로 완전히 새로운 최고 성능의 모델인 Transformer를 만들었습니다.”
4. Model Architecture
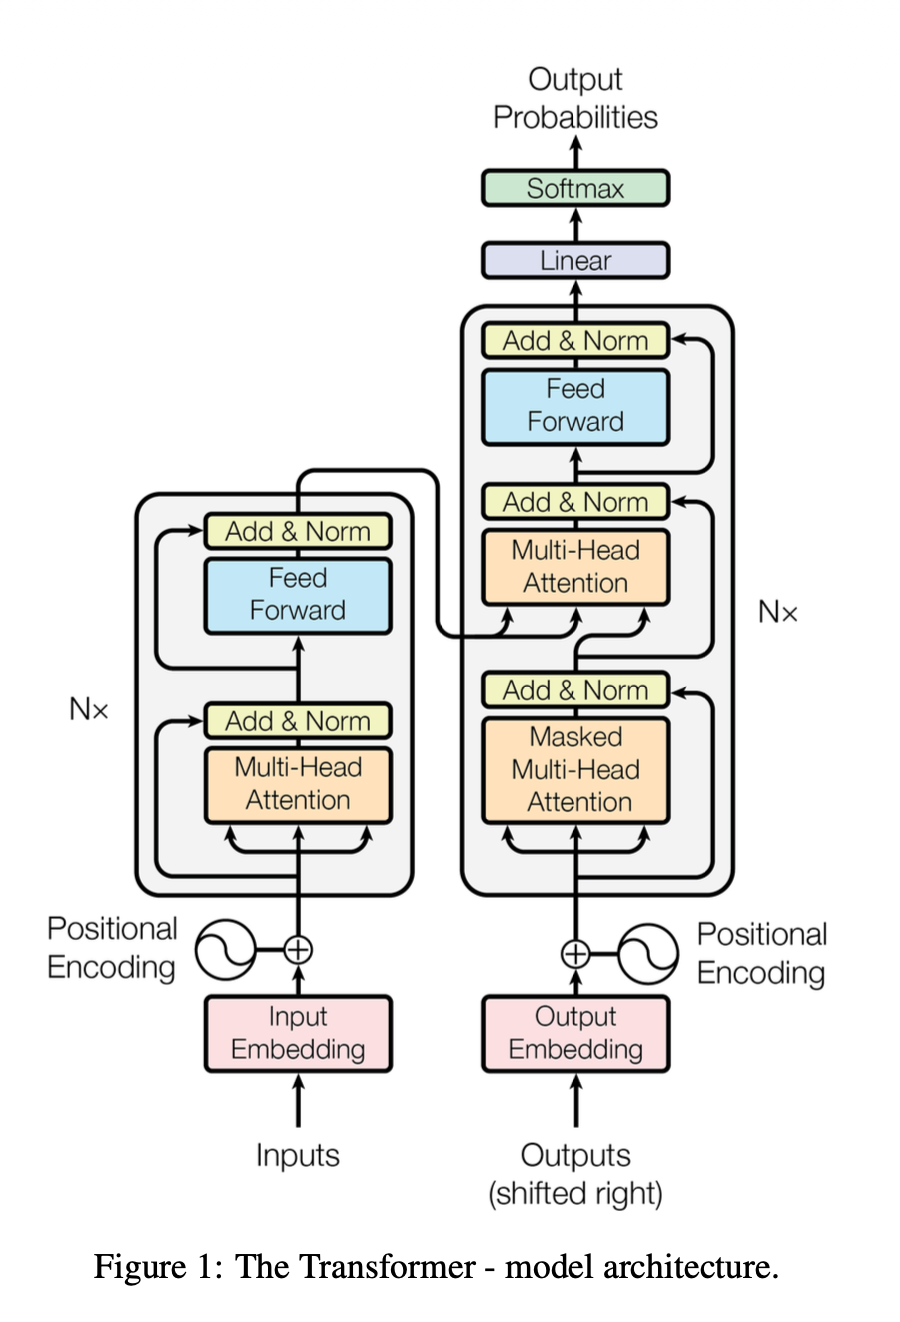
대부분의 경쟁력 있는 Sequence Transduction 모델들은 대개 인코더-디코더(Encoder-Decoder) 구조를 가집니다.
- Encoder (인코더): 입력 시퀀스 $(x_1, \dots, x_n)$을 연속적인 표현(Continuous representations)인 $\mathbf{z} = (z_1, \dots, z_n)$으로 매핑합니다.
- Decoder (디코더): 인코더의 출력인 $\mathbf{z}$를 받아 최종 출력 시퀀스 $(y_1, \dots, y_m)$을 한 번에 한 단어씩 자기회귀적(Auto-regressive)으로 생성합니다. 즉, 다음 단어를 만들 때 이전에 자신이 생성했던 단어들을 다시 입력으로 사용합니다.
Transformer 역시 이 거대한 인코더-디코더 구조를 그대로 따르되, 내부를 RNN 대신 Self-Attention과 Point-wise Feed-Forward Networks로 채워 아키텍처를 구성합니다.
4.1. Encoder and Decoder Stacks (인코더와 디코더 적층 구조)
1. Encoder Stack
인코더는 총 $N = 6$개의 동일한 레이어를 세로로 쌓아 올린 구조입니다. 각 레이어는 내부에 2개의 서브 레이어를 가지고 있습니다.
- 1st Sub-Layer: Multi-Head Self-Attention
- 2nd Sub-Layer: Position-wise Feed-Forward Network
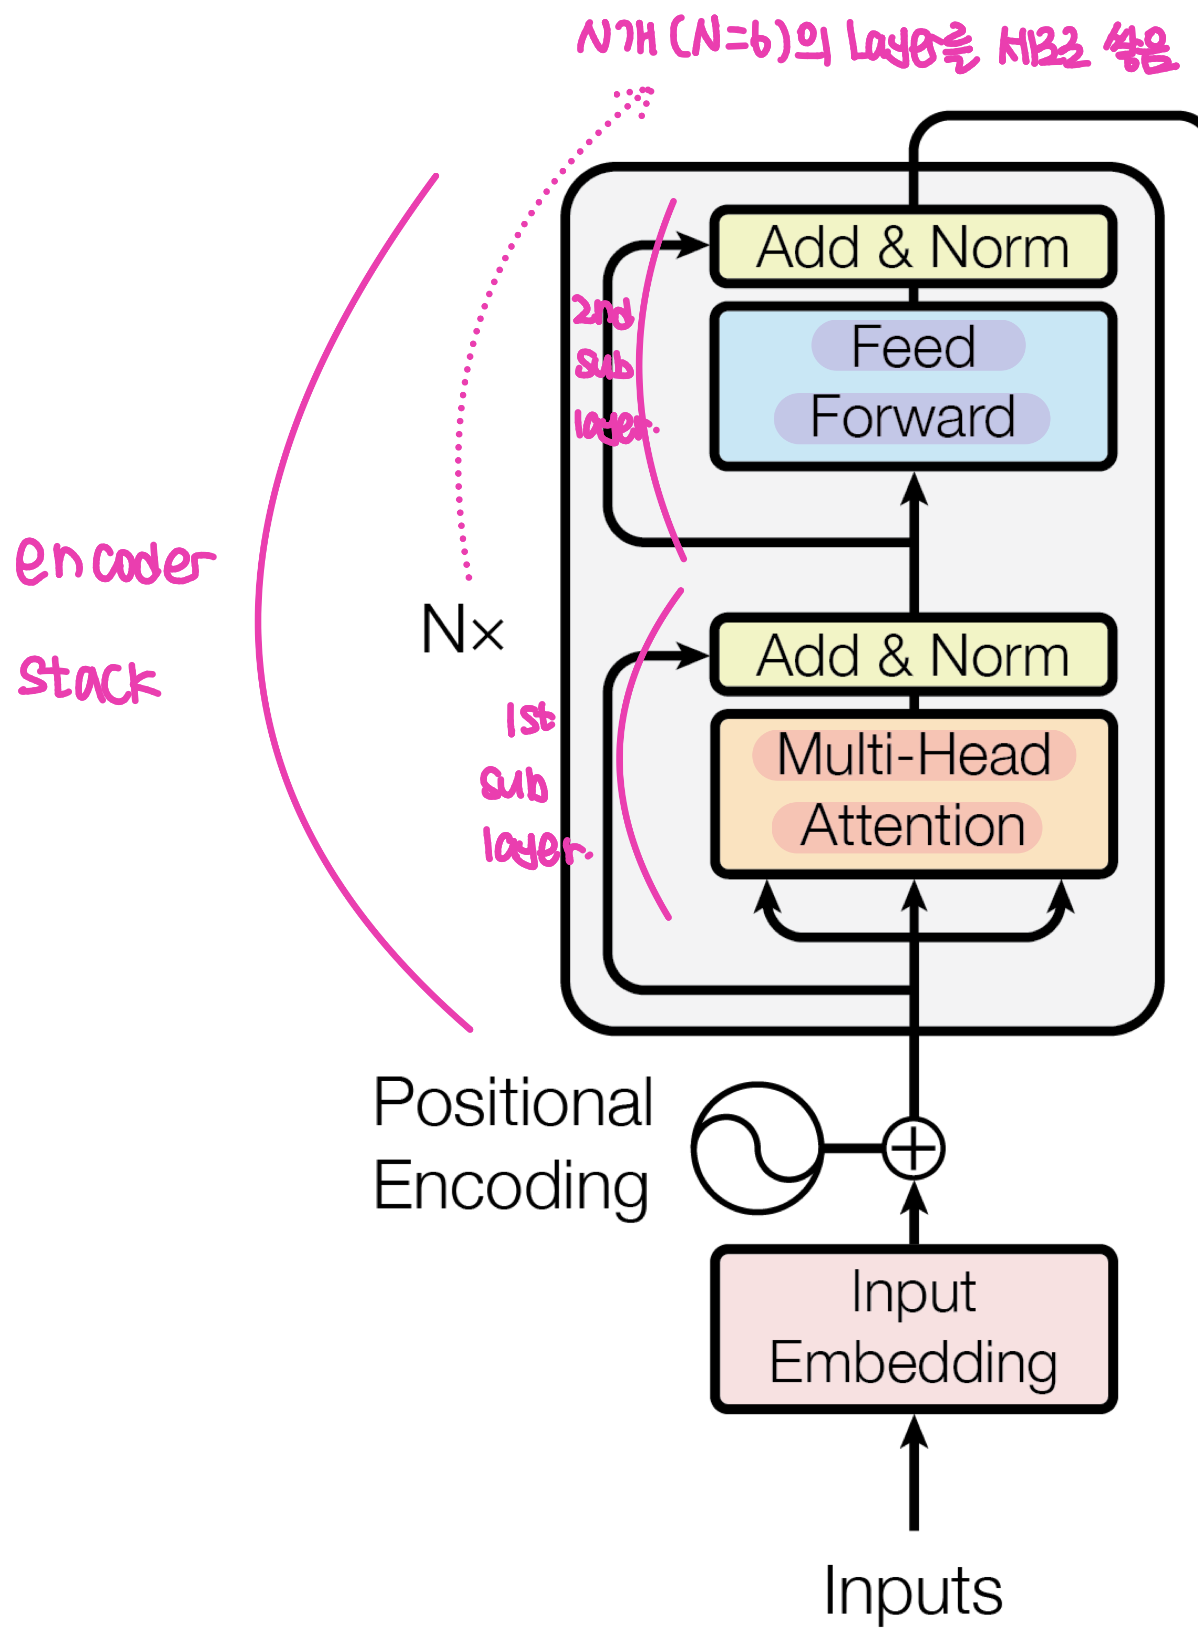
학습을 안정적으로 돕기 위해, 두 서브 레이어 주변에는 잔차 연결(Residual Connection)을 도입했고, 그 후 레이어 정규화(Layer Normalization)를 적용했습니다. 즉, 각 서브 레이어의 최종 출력 형식은 다음과 같습니다.
\[\text{LayerNorm}(x + \text{Sublayer}(x))\]이 잔차 연결을 매끄럽게 더해주려면 차원이 동일해야 하므로, 모델 내부의 모든 Embedding 차원과 서브 레이어의 출력 차원은 $d_{\mathrm{model}} = 512$로 통일되어 있습니다.
- 잔차 연결(Residual Connection)이란? 서브 레이어(예: Multi-Head Attention)를 거쳐서 나온 결과물에, 서브 레이어에 들어가기 전의 원래 입력값($x$)을 그대로 더해주는 것을 말합니다. 아키텍처 구조도에서 박스를 거치지 않고 옆으로 우회해서 위로 올라가는 화살표가 바로 이 장치입니다.
- 필요한 이유: 인코더와 디코더를 6층씩 쌓다 보면 레이어를 거칠수록 앞쪽에서 전해진 중요한 정보가 흐려지거나, 역전파 과정에서 미분값이 0에 가까워져 앞쪽 레이어의 학습이 멈추는 경사 소실(Gradient Vanishing) 문제가 발생할 수 있습니다.
- 해결 방안: 원래 입력인 $x$를 아무런 연산 없이 뒤로 직접 전달해 줌으로써, 아무리 층이 깊어져도 초기 입력 정보가 손실 없이 상위 레이어와 역전파 통로로 전달될 수 있게 만듭니다.
- Layer Normalization이란? 잔차 연결을 통해 $x + \text{Sublayer}(x)$ 연산을 수행하고 나면, 이 값을 다음 레이어로 보내기 전에 정규화(Normalization)를 해줍니다. 데이터의 값들이 너무 들쭉날쭉하지 않도록 특정 범위(예: 평균 0, 분산 1)가 되도록 통일시켜 주는 작업입니다.
- Layer Normalization의 특징: 딥러닝에는 Batch Normalization 등 다양한 방법이 있지만, Transformer는 하나의 문장(하나의 샘플) 안에서 각 단어(토큰) 벡터들의 특징 차원들을 기준으로 평균과 분산을 구해 정규화하는 방식을 사용합니다.
- 존재 이유: 행렬 연산을 계속 거치다 보면 출력값들의 분포가 무작위로 커지거나 한쪽으로 치우치는 현상이 발생합니다. 값이 지나치게 커지면 활성화 함수를 통과할 때 학습이 불안정해집니다. 레이어 정규화를 거치면 모든 레이어의 입력 분포가 일정하게 유지되어 학습 속도가 빨라지고, 초기 가중치 설정에 덜 민감해지며, 안정적으로 수렴하게 됩니다.
2. Decoder Stack
디코더 역시 $N = 6$개의 동일한 레이어를 쌓아 올립니다. 다만 디코더는 인코더의 정보를 가져와서 연산해야 하므로, 인코더보다 하나 더 많은 3개의 서브 레이어를 가집니다.
- 1st Sub-Layer: (디코더 내의) Masked Multi-Head Attention (미래의 단어를 미리 보고 커닝하는 것을 막기 위해 마스킹 추가)
- 2nd Sub-Layer: Multi-Head Attention (인코더의 출력 정보를 받아와서 처리하는 ‘Decoder-Encoder Attention’)
- 3rd Sub-Layer: Position-wise Feed-Forward Network
디코더 역시 모든 서브 레이어에 잔차 연결과 레이어 정규화를 똑같이 적용합니다.
💡 인코더/디코더 레이어 수($N=6$)와 서브 레이어 구조의 결정 배경
- 왜 $N=6$인가? ➡️ 다양한 숫자로 실험을 거치며 연산 속도와 모델의 성능(BLEU 점수) 사이에서 가장 최적의 타협점을 찾은 결과가 6입니다. 이후 BERT나 GPT 등의 모델에서는 이 레이어 수를 크게 늘려 성능을 극대화하게 됩니다. 즉, 6개의 레이어는 실용적인 성능과 자원 효율 사이의 타협선입니다.
- 서브 레이어의 구조와 개수? ➡️ 인코더에 2개, 디코더에 3개를 배치한 것 역시 실험적 아키텍처 설계의 결과입니다. Attention 레이어는 “문맥과 의미적 관계를 파악하는 역할”을 하고, Feed-Forward 레이어는 파악된 특징들을 “비선형적으로 융합하고 가공하는 역할”을 합니다. 이 두 가지 역할이 상호보완적으로 작용해야만 고차원의 추상적인 의미를 안정적으로 학습할 수 있기 때문에 이 세트 구조를 정립하였습니다.
4.2. Attention
Attention은 한마디로 정리하면, “Query(질문)를 Key(식별자)-Value(값) 쌍의 세트와 연관 지어 최적의 정보를 뽑아내는 함수”입니다.
Query, Keys, Values, 그리고 최종 출력(Output)은 모두 벡터 형태입니다. 출력 벡터는 Value 벡터들의 가중합(Weighted sum)으로 계산되는데, 이때 각 Value에 곱해지는 가중치(Weight)는 Query와 해당 Key의 유사도(호환성 함수, Compatibility Function)에 의해 결정됩니다.
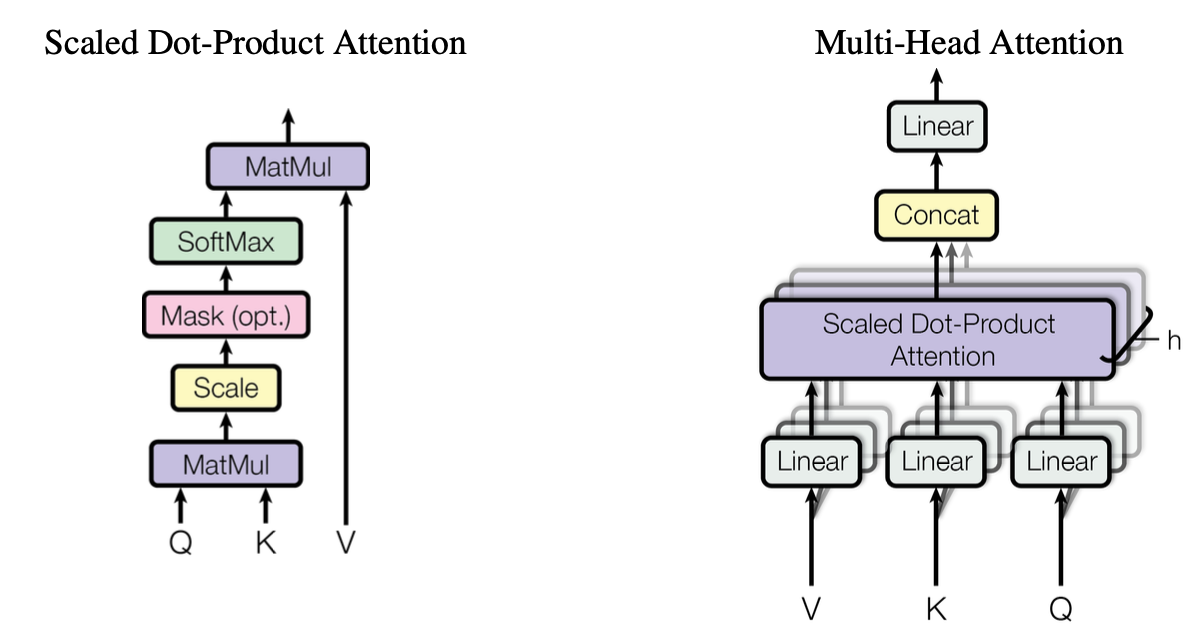
4.2.1. Scaled Dot-Product Attention
저자들이 제안하는 가장 기본적이면서도 빠른 Attention 연산 방식입니다. 입력은 $d_k$ 차원의 Query들과 Key들, 그리고 $d_v$ 차원의 Value들로 이루어집니다. Query와 모든 Key의 내적(Dot product)을 계산하고 각각을 $\sqrt{d_k}$로 나눈 뒤, Softmax 함수를 적용하여 Value들에 대한 가중치를 얻습니다.
\[\text{Attention}(Q, K, V) = \text{softmax}\left(\frac{QK^T}{\sqrt{d_k}}\right)V\]- 왜 하필 Scaled Dot-Product인가? Attention 점수를 계산하는 방법은 크게 1) Additive Attention과 2) Dot-product Attention 두 가지가 존재합니다. Dot-product 방식이 훨씬 빠르고 공간 효율적이지만, 차원 수($d_k$)가 커지면 내적값 자체가 너무 커지는 문제가 발생합니다. 값이 지나치게 커지면 Softmax 함수를 통과할 때 기울기가 극도로 작아지는 Gradient Vanishing 구간에 빠지게 되므로, 이를 방지하기 위해 차원의 제곱근인 $\sqrt{d_k}$로 나누어 스케일링을 해주는 것입니다.
4.2.2. Multi-Head Attention
$d_{\mathrm{model}} = 512$ 차원의 $Q, K, V$를 그냥 통째로 Attention 시키는 것보다, 이를 서로 다르게 학습된 선형 사영(Linear Projections)을 통해 작은 차원으로 여러 번 쪼개서 병렬로 Attention을 수행하는 것이 성능 면에서 훨씬 이득이라는 것을 발견했습니다.
\[\begin{aligned} \mathrm{MultiHead}(Q, K, V) &= \mathrm{Concat}(\mathrm{head}_1, \dots, \mathrm{head}_h)W^O \\ \text{where } \mathrm{head}_i &= \mathrm{Attention}(QW_i^Q, KW_i^K, VW_i^V) \end{aligned}\]✔️ Multi-Head Attention의 연산 과정
- $Q, K, V$를 각각 $h$번(논문에서는 $h=8$개) 서로 다른 학습 가능한 선형 행렬($W_Q, W_K, W_V$)로 프로젝션(Linear Projection) 시킵니다.
- 이 과정에서 쪼개진 차원은 $d_k = d_v = d_{\mathrm{model}} / h = 512 / 8 = 64$가 됩니다.
- 이렇게 쪼개진 64차원짜리 작은 $Q, K, V$ 조각 8세트를 각각 독립적으로 Scaled Dot-Product Attention 수행을 병렬화(Parallel)합니다.
- 구해진 8개의 출력 벡터($\mathrm{head}_1, \dots, \mathrm{head}_8$)를 다시 옆으로 길게 이어 붙인(Concat) 후, 최종 선형 행렬 ($W^O$)과 곱해 원래의 512차원으로 되돌립니다.
- 왜 이게 더 유리할까? 단일 Attention을 사용하면 문장 전체의 평균적인 정보만 보게 됩니다. 반면 Multi-Head Attention을 사용하면, $\mathrm{head}_1$은 ‘주어와 동사의 관계’를 보고, $\mathrm{head}_2$는 ‘형용사와 명사의 관계’를 보는 등 다양한 위치에서 서로 다른 서브 스페이스의 정보에 동시에 집중할 수 있게 됩니다. 게다가 전체 연산 비용은 단일 Attention을 사용했을 때와 비슷합니다.
4.2.3. Applications of Attention in our Model
Transformer 내부에서는 이 Multi-Head Attention을 구체적으로 세 가지 용도로 다르게 분류하여 사용합니다.
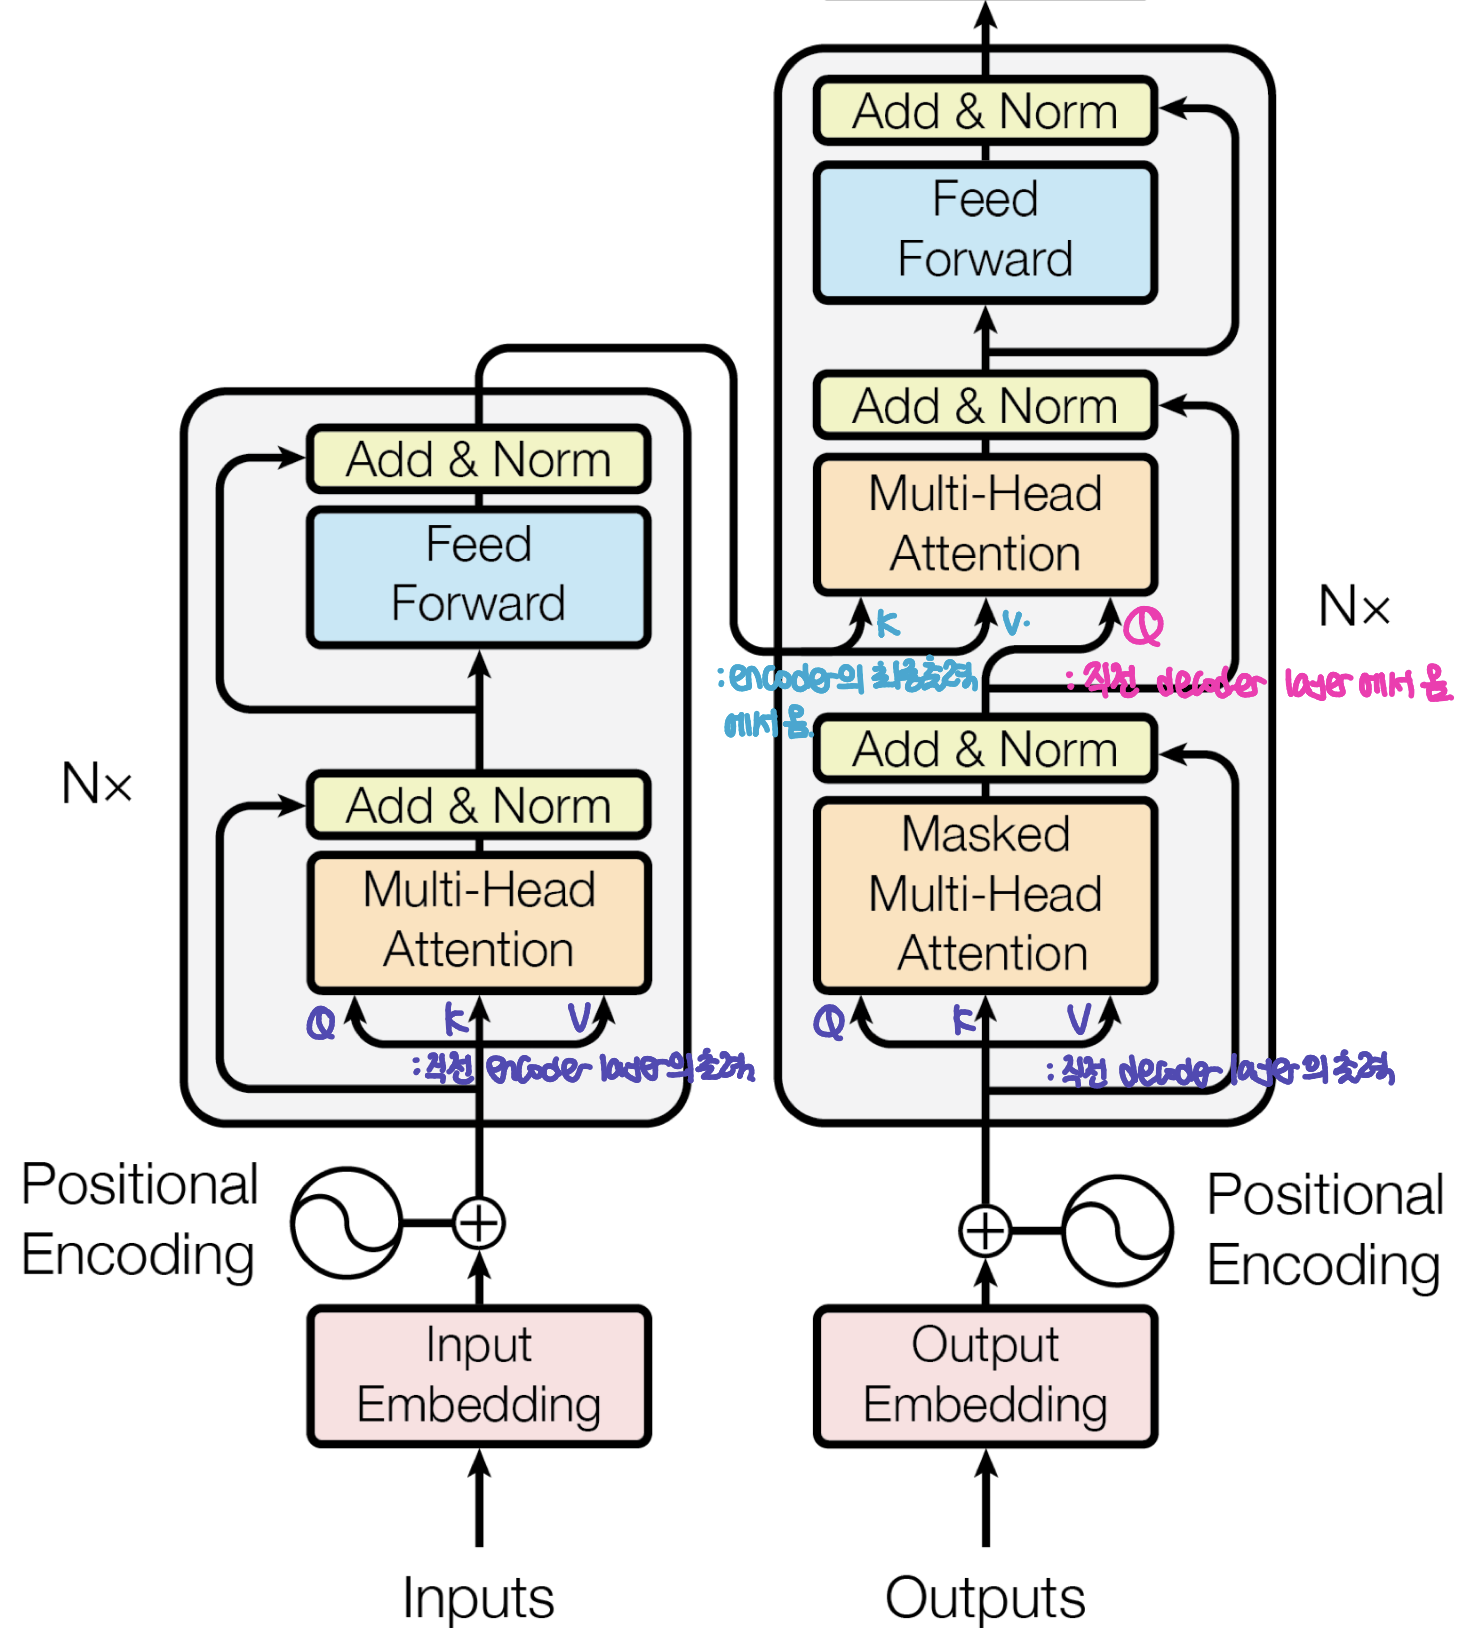
- Encoder Self-Attention (인코더의 셀프 어텐션):
- Query, Key, Value가 모두 직전 인코더 레이어의 출력에서 옵니다. 즉, 인코더의 각 위치는 인코더의 ‘모든’ 위치를 돌아보며 관계를 학습합니다.
- Decoder Self-Attention (디코더의 셀프 어텐션):
- Query, Key, Value가 모두 직전 디코더 레이어의 출력에서 옵니다.
- ⚠️ 다만 디코더는 단어를 순차적으로 맞춰야 하므로 미래의 단어를 보아서는 안 됩니다. 이를 막기 위해 Scaled Dot-Product Attention 내부 Softmax의 입력 중 미래 시점 위치를 마이너스 무한대($-\infty$)로 밀어버리는 마스킹(Masking)을 적용합니다. 이러면 Softmax를 거쳤을 때 미래 단어의 가중치가 0이 되어 완벽히 차단됩니다.
- Encoder-Decoder Attention (인코더-디코더 어텐션):
- Query는 직전 디코더 레이어에서 오고, Key와 Value는 인코더의 최종 출력에서 가져옵니다.
- 이를 통해 디코더의 모든 위치가 입력 문장(인코더 내용) 전체의 어떤 단어에 집중해야 하는지(전형적인 번역기 구조)를 결정하게 됩니다.
👆 Scaled Dot-Product와 Multi-Head Attention의 관계 정리 아키텍처 다이어그램에 보이는 ‘Attention’ 레이어는 모두 Multi-Head Attention에 해당합니다. Scaled Dot-Product Attention은 Multi-Head Attention의 내부 연산을 담당하는 핵심 부품입니다. 즉, 모델의 어떤 위치에 있는 Attention이든 기본 연산은 Scaled Dot-Product 방식을 취하되, 이를 한 번만 계산하는 것이 아니라 Head를 8개로 쪼개어 병렬로 처리하는 Multi-Head 방식으로 작동하는 아키텍처 메커니즘입니다.
4.3. Position-wise Feed-Forward Networks
인코더와 디코더의 각 레이어에는 어텐션 서브 레이어 뒤에, 각 위치(단어)마다 독립적으로 동일하게 적용되는 Fully Connected Feed-Forward Network(FFN)가 결합되어 있습니다.
\[\mathrm{FFN}(x) = \max(0, xW_1 + b_1)W_2 + b_2\]Linear 연산을 적용하고 활성화 함수로 ReLU를 거친 뒤, 다시 한번 Linear 연산을 수행하는 구조입니다. 문장 내의 각 위치(Position)마다 동일한 연산 식이 적용되지만, 레이어와 레이어 사이에는 서로 다른 매개변수($W, b$)를 사용합니다. 내부 차원은 입력 $d_{\mathrm{model}}=512$차원을 $d_{ff}=2048$차원으로 크게 확장했다가 다시 512차원으로 축소하는 형태를 가집니다.
4.4. Embeddings and Softmax
다른 시퀀스 변환 모델들과 마찬가지로, 입력 토큰과 출력 토큰을 $d_{\mathrm{model}}=512$ 차원의 벡터로 변환하기 위해 학습 가능한 Embedding을 사용합니다. 또한 디코더의 최종 출력을 다음 토큰의 예측 확률로 바꾸기 위해 선형 레이어와 Softmax 함수를 결합하여 사용합니다.
특이한 점은, 본 논문에서는 두 임베딩 레이어(인코더, 디코더)와 Softmax 직전의 선형 레이어에 동일한 가중치 행렬(Weight Matrix)을 공유해서 사용(Weight Sharing)했다는 점입니다. 다만 임베딩 레이어에서는 이 가중치에 $\sqrt{d_{\mathrm{model}}}$을 곱해주는 스케일링 처리를 더했습니다.
- 학습 가능한 Embedding의 선형대수학적 의미 컴퓨터는 ‘사과’, ‘바나나’ 같은 문자열 단어를 직접 이해하거나 연산할 수 없습니다. 따라서 단어를 숫자로 이루어진 공간(벡터 공간)에 배치해야 하는데, 이를 Embedding이라고 합니다.
- 학습 가능하다는 뜻은? 처음 모델을 설계했을 때는 컴퓨터가 단어의 의미를 전혀 모릅니다. 그래서 무작위 숫자로 채워진 512차원 벡터 공간에 단어들을 아무렇게나 흩뿌려 둡니다. 하지만 모델이 대규모 문장을 읽고 학습하며 역전파(Backpropagation) 과정을 거치면 이 벡터 공간 안의 좌표 값들이 정교하게 업데이트됩니다.
- 결과적인 혜택: 학습이 완벽히 끝난 후에는 의미가 비슷한 단어(예: 고양이와 강아지)끼리 벡터 공간 상에서 물리적으로 가까운 거리에 위치하게 되고, 단어 간의 문법적·의미적 관계도 벡터의 방향성(유사도)으로 표현됩니다. 즉, 모델이 단어의 의미와 관계를 깨우치며 데이터에 맞게 최적화되는 임베딩 벡터를 스스로 만들어 낸다는 의미입니다.
4.5. Positional Encoding
Transformer는 RNN이나 CNN을 전혀 사용하지 않기 때문에, 문장 안에 단어들이 들어오는 ‘순서나 위치 정보’가 모델 자체에는 전혀 입력되지 않습니다. 모델 입장에서는 단어들이 순서 없이 사방으로 흩어진 주머니(Bag of Words)처럼 보일 수 있는 치명적인 문제가 존재합니다.
이를 해결하기 위해 시퀀스 내 토큰의 상대적 또는 절대적 위치 정보를 주입하는 Positional Encoding을 인코더와 디코더의 가장 밑단(Input Embedding 직후)에 더해줍니다. Positional Encoding 벡터의 차원도 $d_{\mathrm{model}}=512$로 똑같기 때문에, 기존 임베딩 벡터와 그대로 더하기(Addition) 연산을 수행할 수 있습니다.
저자들은 다양한 주기를 가진 사인(Sine) 함수와 코사인(Cosine) 함수를 결합하여 이용합니다.
\[\begin{aligned} PE_{(\mathrm{pos}, 2i)} &= \sin\left(\mathrm{pos} / 10000^{2i / d_{\mathrm{model}}}\right) \\ PE_{(\mathrm{pos}, 2i+1)} &= \cos\left(\mathrm{pos} / 10000^{2i / d_{\mathrm{model}}}\right) \end{aligned}\]- $\mathrm{pos}$: 단어의 절대적인 위치 고유 번호
$i$: 차원의 인덱스 (첫 번째 식의 경우, 파장이 $2\pi$에서 $10000 \times 2\pi$까지 기하급수적으로 증가)
- 왜 하필 주기 함수(sin/cos)인가? 이 주기 함수를 사용하면 특정 오프셋(거리) $k$에 대해 $PE_{(\mathrm{pos}+k)}$가 $PE_{(\mathrm{pos})}$의 선형 함수로 표현될 수 있어, 모델이 상대적인 위치 관계를 아주 쉽게 학습할 수 있습니다. 저자들은 학습 가능한 포지션 임베딩도 실험해 보았으나 결과가 거의 동일했고, 고정된 sin/cos 방식을 쓰면 학습 때 본 적이 없는 엄청나게 긴 문장이 들어와도 위치를 유연하게 유추(Extrapolate)할 수 있다는 강력한 장점이 있어 이 방식을 최종 선택했습니다.
💡 “고정된 오프셋 $k$에 대해 $PE_{(\mathrm{pos}+k)}$가 $PE_{(\mathrm{pos})}$의 선형 함수로 표현될 수 있다”는 것의 의미 $\mathrm{pos}$라는 위치에 있는 단어와, 여기서 $k$만큼 떨어진 $\mathrm{pos} + k$ 위치의 단어를 비교해 보겠습니다. 삼각함수의 덧셈 정리를 적용하면, $\mathrm{pos} + k$ 위치의 포지셔널 인코딩 값인 $PE_{(\mathrm{pos} + k)}$는 기존 $PE_{(\mathrm{pos})}$ 값에 $k$에 대한 sin/cos 값을 적절히 곱하고 더하는 형태(선형 결합)로 쪼갤 수 있습니다.
즉, $PE_{(\mathrm{pos} + k)} = PE_{(\mathrm{pos})} \times M$ 구조로 표현이 가능하며, 여기서 행렬 $M$은 오직 떨어진 거리 $k$에 의해서만 결정되는 고정된 행렬이 됩니다. 덕분에 모델은 절대적 위치뿐만 아니라 단어 사이의 상대적 거리 차이까지 선형적으로 쉽게 인지할 수 있게 됩니다.
5. Why Self-Attention?
RNN 및 CNN과 비교하여 Self-Attention의 당위성을 세 가지 측면에서 비교하여 입증한다. 다음 table을 확인하면 명확하게 알 수 있다.
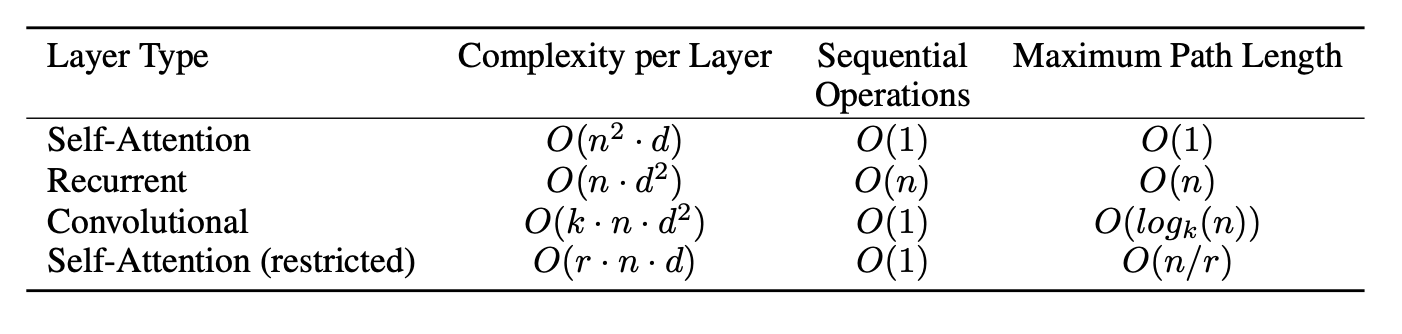 Table 1: 레이어당 총 계산 복잡도, 최소한의 순차 연산, 최대 경로 길이. $n$은 시퀀스 길이(sequence length), $d$는 표현 차원(representation dimension), $k$는 합성곱의 커널 크기(kernel size of convolution), $r$은 제한된 self-attention에서의 이웃 크기(size of neighborhood in restricted self-attention)이다.
- 비교를 위한 세 가지 핵심 기준
- 레이어당 총 계산 복잡도: 연산량이 얼마나 적고 효율적인가?
- 병렬화 가능한 연산량: 최소한으로 필요한 순차 연산의 수가 적어 병렬 처리가 잘 되는가?
- 장거리 의존성 간의 경로 길이: 네트워크 안에서 멀리 떨어진 단어 조합끼리 신호가 오고 가는 경로가 얼마나 짧은가. (이유: 신호가 거쳐야 하는 경로가 짧을수록 장거리 의존성을 학습하기가 훨씬 쉽기 때문)
- 레이어 타입별 세부 비교 (Table 1 분석)
- Self-Attention: 문장의 모든 단어 쌍을 한 번에 연결하므로 최대 경로 길이가 단 $O(1)$(상수 시간)이다. 일반적으로 번역 문장에서의 문장 길이($n$)가 차원 수($d$)보다 작은 경우가 대부분이므로, RNN보다 계산 속도도 빠르다. 만약 문장이 너무 길어지면 연산량을 줄이기 위해 자기 주변 $r$ 크기의 이웃만 보는 ‘제한된 self-attention(Restricted Self-Attention)’을 쓸 수도 있으며, 이 경우 복잡도는 $O(r \cdot n \cdot d)$, 경로는 $O(n / r)$이 된다.
- RNN/LSTM: 단어를 무조건 순서대로 처리해야 하므로 $O(n)$만큼의 순차 연산이 강제되어 병렬 처리가 불가능하다. 문장 맨 앞 단어와 맨 뒤 단어가 신호를 주고받으려면 문장 길이 $n$만큼의 단계를 거쳐야 하므로 장거리 의존성 학습이 어렵다.
- CNN: 모든 위치를 동시에 계산할 수 있어 병렬화는 좋지만, 커널 크기의 제한 때문에 멀리 떨어진 두 단어를 연결하려면 레이어를 높게 쌓아야 해서 경로가 길어진다. 대안으로 분리형 합성곱(Separable Convolution)을 쓰면 복잡도를 낮출 수 있지만, $k = n$이 되면 이는 결국 Transformer가 채택한 self-attention + feed-forward 구조의 복잡도와 같아진다.
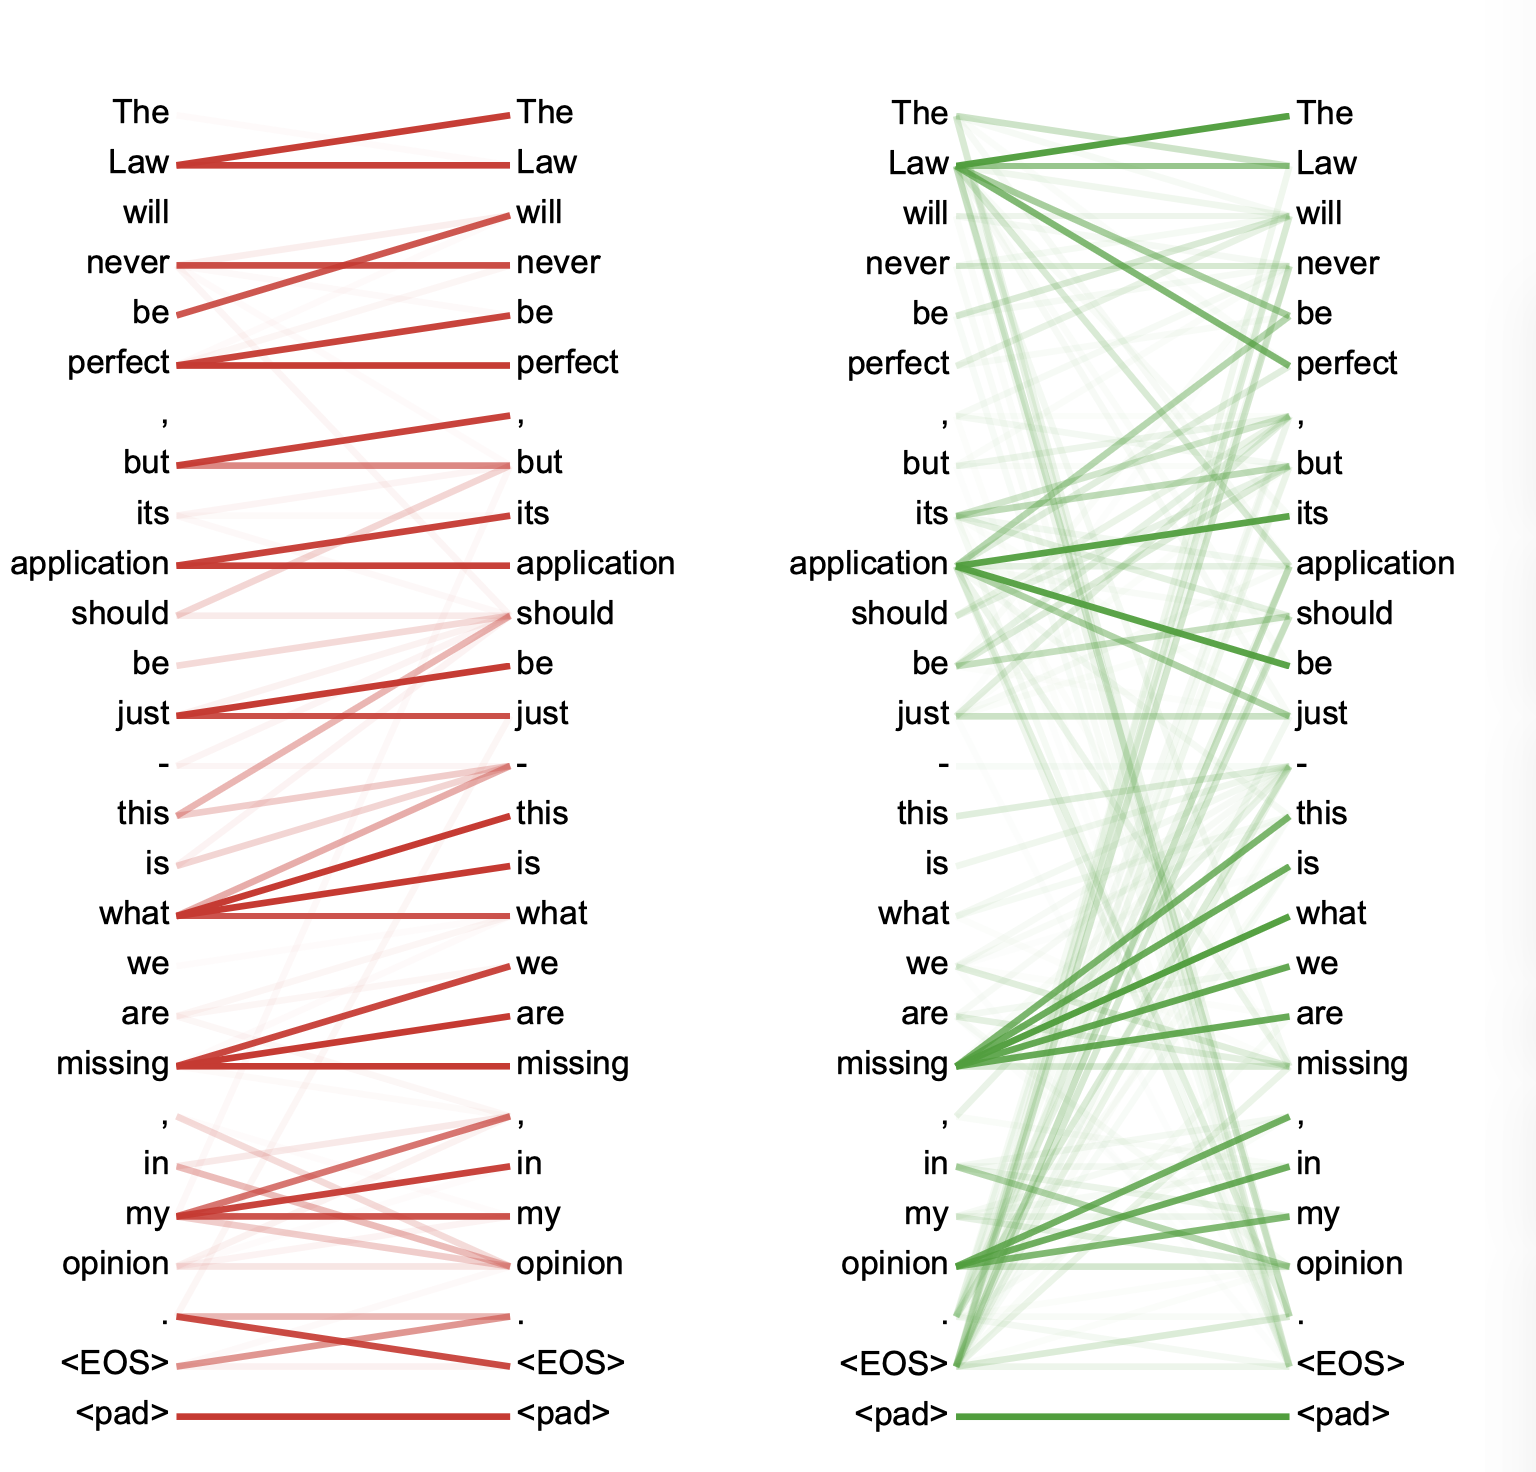
부가적 이점: 모델의 해석 가능성
→ Self-attention을 사용하면, 모델이 문장을 어떻게 이해하는지 시각적으로 직접 확인할 수 있다. 아래 사진을 보면, 개별 어텐션 헤드들이 인간이 학습하는 문법적, 의미적 구조를 스스로 학습하여 강하게 연결하고 있음을 직관적으로 보여준다.
6. Conclusion
- 연구의 요약
- Transformer는 오직 Attention에만 기반한 최초의 시퀀스 변환 모델이다.
- 기존 인코더-디코더 아키텍처에서 가장 흔하게 쓰이던 Recurrent Layer(RNN)를 Multi-Head Self-Attention으로 완벽하게 대체하였다.
- Transformer의 의의
- 번역 Task에서 Recurrent나 Convolutional 레이어 기반의 모델들보다 획기적으로 빠르게 학습할 수 있다.
- WMT 2014 영어-독일어 및 영어-프랑스어 태스크 모두에서 기존의 앙상블 모델까지 제치고 새로운 최고성능(SOTA)을 달성했다.
- 향후 연구 방향
- 저자들은 어텐션 기반 모델의 잠재력에 크게 고무되었으며, 향후 이 아키텍처를 텍스트뿐만 아니라 이미지, 오디오, 비디오 등 다른 모달리티(Modality)를 포함하는 문제로 확장할 계획을 밝혔다.
- 매우 긴 입력과 출력을 효율적으로 처리하기 위해, 본문에서 언급한 ‘지역적으로 제한된 어텐션 메커니즘(Local, restricted attention mechanism)’을 더 깊게 연구할 예정이다.
- 디코더가 단어를 하나씩 순차적으로 생성하는 순방향 연산 과정을 한층 더 효율화할 것이다.
본 포스팅을 통해 Transformer의 근간이 되는 논문인 ‘Attention Is All You Need’를 리뷰해 보았다. 다음 포스팅에서는, 해당 논문을 더 이해하기 쉽게 정리하고, 어려웠던 부분을 따로 정리해보고자 한다.