[논문 리뷰] UDAPose _ Unsupervised Domain Adaptation for Low-Light Human Pose Estimation
실제 저조도 특성을 반영한 데이터 합성과 visual cue·pose prior의 동적 결합으로 Low-Light Human Pose Estimation을 개선하는 UDAPose 논문 핵심 리뷰
Paper Information
- Title: UDAPose: Unsupervised Domain Adaptation for Low-Light Human Pose Estimation
- Authors: Haopeng Chen, Yihao Ai, Kabeen Kim, Robby T. Tan, Yixin Chen, Bo Wang
- Conference: CVPR 2026
- Paper: arXiv:2604.10485
- Code: Vision-and-Multimodal-Intelligence-Lab/UDAPose
Abstract & Conclusion
1. 문제 제기: 왜 Low-Light Human Pose Estimation이 어려운가?
Human Pose Estimation(HPE)은 사람의 어깨, 팔꿈치, 손목, 무릎, 발목 등의 keypoint를 찾는 task입니다.
최근 HPE 모델의 성능은 크게 발전했지만, 대부분의 모델과 benchmark는 정상적인 조명(Well-lit) 환경을 중심으로 학습·평가됩니다.
문제는 실제 환경에서는 야간, CCTV, 실내 저조도 등 Low-Light Condition이 흔하다는 점입니다.
저조도에서는 크게 두 가지 문제가 발생합니다.
- 시각 정보 손실
- contrast가 낮아지고,
- noise가 증가하며,
- 사람의 윤곽과 관절 주변 texture가 사라집니다.
- 결국 pose estimator가 사용할 수 있는 Visual Cue가 약해집니다.
- 라벨이 달린 실제 Low-Light Dataset 부족
- 일반 HPE dataset은 많지만, 실제 저조도 이미지에 정확한 keypoint annotation이 달린 dataset은 많지 않습니다.
- 특히 이미지 자체가 어두우면 사람이 직접 annotation하는 것도 어렵습니다.
즉, 문제를 간단히 표현하면 다음과 같습니다.
\[\text{Train: Well-lit} \quad \rightarrow \quad \text{Test: Low-light}\]이때 두 환경의 데이터 분포 차이인 Domain Gap이 발생하면서 HPE 성능이 크게 떨어집니다.
2. 기존 접근의 한계
저조도 HPE를 해결하는 대표적인 방법은 크게 세 가지로 볼 수 있습니다.
2.1 Low-Light Image Enhancement
먼저 저조도 이미지를 밝게 복원한 뒤 pose estimation을 수행하는 방법입니다.
\[I_{\text{LL}} \rightarrow \text{Enhancement} \rightarrow \text{Pose Estimator}\]하지만 심하게 손실된 정보를 완벽하게 복원하는 것은 본질적으로 어려우며, enhancement 과정에서 artifact가 생기면 오히려 pose estimation에 악영향을 줄 수 있습니다.
또한 사람 눈에 보기 좋은 이미지와 pose estimator가 사용하기 좋은 이미지가 반드시 같은 것은 아닙니다.
2.2 Handcrafted Low-Light Augmentation
Well-lit image를 단순히 어둡게 만들거나 noise를 추가하여 synthetic low-light image를 생성하는 방식입니다.
예를 들면,
\[I_{\text{dark}} = \alpha I_{\text{bright}}, \quad \alpha < 1\]또는 Gaussian noise를 추가하는 방식입니다.
장점은 기존 well-lit 이미지의 pose annotation을 그대로 사용할 수 있다는 것입니다.
그러나 실제 저조도에서 발생하는 noise는 단순 Gaussian noise가 아닙니다.
- Photon noise
- Thermal noise
- Quantization noise
- Sensor-dependent noise
- 복잡한 spatial degradation
등이 함께 발생할 수 있습니다.
따라서 단순한 rule-based augmentation은 실제 저조도 특성을 충분히 재현하지 못합니다.
2.3 Learning-based Image Translation
CycleGAN, StyleID와 같은 image translation 방법으로
\[\text{Well-lit} \rightarrow \text{Synthetic Low-light}\]변환을 학습할 수도 있습니다.
하지만 저자들은 기존 방법이 전체적인 색감이나 밝기와 같은 Low-frequency appearance는 바꿀 수 있어도, 실제 저조도에서 중요한 High-frequency characteristics를 충분히 재현하지 못한다고 지적합니다.
여기서 High-frequency 정보는 대표적으로 다음과 같습니다.
- pixel-level noise
- edge
- fine texture
- 작은 밝기 변화
- 세밀한 구조적 detail
즉,
“어두워 보이는 이미지”를 만드는 것과 “실제 저조도 카메라로 촬영된 것 같은 이미지”를 만드는 것은 다르다.
라는 것이 핵심 문제입니다.
3. 또 하나의 문제: Pose Estimator가 Visual Cue를 너무 믿는다
최근 Transformer/DETR 기반 HPE 모델은 이미지 feature에서 keypoint 정보를 가져오기 위해 cross-attention을 사용합니다.
여기서 Visual Cue란 이미지 자체에서 얻는 시각적 단서를 의미합니다.
예를 들면,
- 팔의 윤곽
- 피부와 옷의 경계
- 관절 주변의 edge
- 사람의 silhouette
- local texture
등입니다.
밝은 환경에서는 이러한 visual cue가 신뢰할 만합니다.
하지만 저조도에서는
\[\text{Low-light} \rightarrow \text{Visual Cue Reliability} \downarrow\]가 됩니다.
그럼에도 기존 모델은 image cue와 pose prior를 거의 고정적으로 합칩니다.
저자들의 분석에서는 기존 모델의
\[\frac{\|Q_{\text{image}}\|_2}{\|Q_{\text{pose}}\|_2}\]비율이 잘 보이는 keypoint와 거의 보이지 않는 keypoint에서 모두 비슷하게 유지되었습니다.
즉,
“관절이 안 보이는데도 모델이 여전히 이미지 정보를 강하게 믿는다.”
는 문제가 있습니다.
4. 해결책: UDAPose
UDAPose는 위의 두 문제를 동시에 해결합니다.
- 실제 Low-Light 특성을 가진 Synthetic Training Data 생성
- Stable Diffusion
- DHF (Direct-Current-based High-Pass Filter)
- LCIM (Low-Light Characteristics Injection Module)
- Visual Cue와 Pose Prior의 동적 결합
- DCA (Dynamic Control of Attention)
전체 흐름은 다음과 같습니다.
\[I_{\text{WL}} + I_{\text{LL}} \rightarrow \text{DHF + LCIM + Stable Diffusion} \rightarrow \hat{I}_{\text{LL}}\]그 뒤,
\[\hat{I}_{\text{LL}} \rightarrow \text{Pose Estimator + DCA} \rightarrow \text{Keypoint Prediction}\]여기서 중요한 점은 실제 Low-Light 이미지의 pose annotation이 필요하지 않다는 것입니다.
실제 low-light 이미지는 단지 저조도 특성을 제공하는 reference로 사용되며, pose label은 기존 well-lit image에서 그대로 가져옵니다.
5. 핵심 결과
UDAPose는 ExLPose와 EHPT-XC에서 기존 방법보다 높은 성능을 보였습니다.
특히 ExLPose-test의 Low-Light Hard(LL-H) subset에서 기존 최고 방법보다 +10.1 AP를 기록했으며, cross-dataset 평가인 EHPT-XC에서도 +7.4 AP를 기록했습니다.
ExLPose-test에서의 AP는 다음과 같습니다.
| Method | LL-A | LL-N | LL-H | LL-E |
|---|---|---|---|---|
| CycleGAN | 19.6 | 33.7 | 17.9 | 3.3 |
| ELLA | 18.6 | 32.3 | 17.2 | 3.4 |
| UDAPose | 27.0 | 38.7 | 28.0 | 11.7 |
특히 조명 조건이 심각해질수록 UDAPose의 상대적인 장점이 커지는 것이 특징입니다.
6. Conclusion
UDAPose의 핵심 주장은 다음과 같이 정리할 수 있습니다.
Low-Light HPE를 잘하려면 단순히 이미지를 어둡게 만드는 것만으로는 부족하다. 실제 저조도의 세밀한 특성을 학습 데이터에 반영해야 하며, 동시에 이미지가 잘 보이지 않을 때는 visual cue를 무조건 신뢰하지 말고 learned pose prior를 더 활용해야 한다.
UDAPose는 이를 위해
- DHF로 실제 low-light의 high-frequency 정보를 보존하고,
- LCIM으로 이를 synthetic image에 multi-scale로 주입하며,
- DCA로 visual cue와 pose prior의 비중을 keypoint별로 동적으로 조절합니다.
👆 챕터 총정리
UDAPose는 단순한 “저조도 이미지 생성 논문”도 아니고, 단순한 “새로운 pose estimator 논문”도 아닙니다.
① 더 현실적인 Low-Light Training Data를 만들고
② 저조도에 강한 Pose Estimator를 함께 설계하는 Domain Adaptation Framework
라는 것이 핵심입니다.
1. Introduction
1.1 Low-Light HPE의 Domain Gap
기존 HPE 모델들은 대부분 COCO, CrowdPose 등 비교적 정상적인 조명 환경의 데이터로 학습됩니다.
그러나 실제 저조도에서는 이미지의 정보가 크게 손실되기 때문에,
\[P_{\text{well-lit}}(x) \neq P_{\text{low-light}}(x)\]라는 domain shift가 발생합니다.
특히 low-light에서는 단순히 밝기만 줄어드는 것이 아니라 noise, contrast, texture, edge 정보도 함께 변합니다.
따라서 well-lit에서 높은 정확도를 보이는 모델이 그대로 low-light에서도 잘 동작할 것이라고 기대하기 어렵습니다.
1.2 실제 Low-Light Annotation을 모으기 어려운 이유
가장 직관적인 해결책은 실제 low-light 이미지를 대량 수집한 뒤 keypoint annotation을 달아 학습하는 것입니다.
그러나 실제 저조도에서는 관절 자체가 잘 보이지 않기 때문에 annotation이 어렵고 비용도 큽니다.
ExLPose는 이러한 문제를 줄이기 위해 paired well-lit / low-light 데이터를 제공합니다. 논문에서 사용하는 ExLPose-test는 optical filtering을 통해 밝기를 약 100배 줄인 이미지로 구성되며, ExLPose-OCN은 A7M3와 RICOH3 카메라로 야간에 촬영한 real low-light image를 포함합니다.
하지만 paired data 수집 자체를 대규모로 확장하기는 어렵습니다.
UDAPose는 여기서 다음 질문을 던집니다.
“Low-light annotation 없이, unlabeled low-light image만으로 well-lit HPE dataset을 low-light domain에 적응시킬 수 없을까?”
1.3 Synthetic Low-Light의 품질이 중요하다
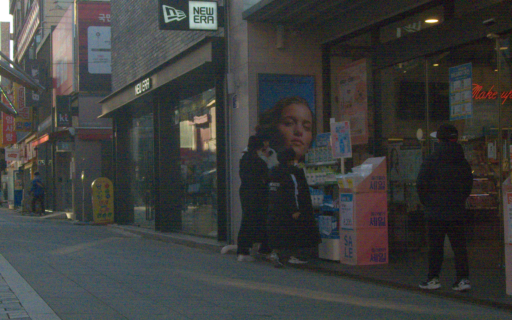
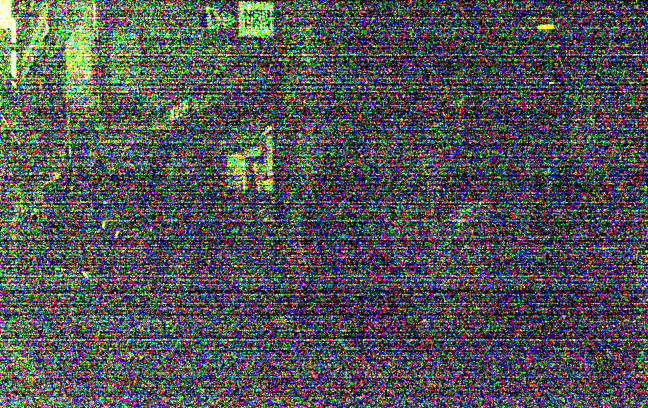
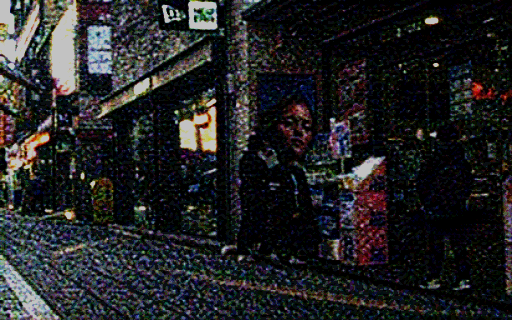
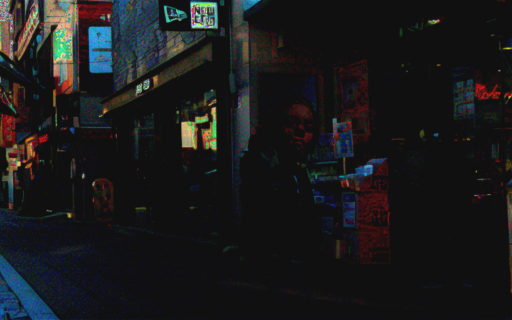
Figure 2: Well-lit / Paired Low-light / CycleGAN / StyleID / UDAPose 합성 결과 비교
Domain adaptation에서는 well-lit image를 low-light처럼 바꾸면 기존 pose annotation을 그대로 활용할 수 있습니다.
\[(I_{\text{WL}}, Y_{\text{pose}}) \rightarrow (\hat{I}_{\text{LL}}, Y_{\text{pose}})\]하지만 synthetic image가 실제 low-light와 다르면, synthetic data에서 학습한 모델이 real low-light에 generalize하지 못합니다.
논문은 특히 기존 방법의 문제를 다음과 같이 지적합니다.
- Handcrafted augmentation: 실제 noise pattern을 지나치게 단순화
- CycleGAN: 지나치게 어둡게 만들거나 illumination artifact 발생
- StyleID: 실제 low-light noise를 충분히 생성하지 못함
따라서 UDAPose는 unpaired real low-light reference image의 실제 특성을 synthetic image에 직접 주입하는 방향을 선택합니다.
1.4 Pose Prior가 필요한 이유
Visual cue가 약해졌다고 해서 사람의 신체 구조 자체가 사라지는 것은 아닙니다.
예를 들어 wrist가 잘 보이지 않더라도,
- shoulder 위치
- elbow 위치
- 인간 팔의 구조
를 알고 있다면 wrist가 있을 가능성이 높은 위치를 추론할 수 있습니다.
이처럼 이미지에서 직접 관찰되는 정보가 아니라 인체 keypoint 사이의 구조적 관계에서 얻는 사전 지식을 이 글에서는 Pose Prior라고 이해할 수 있습니다.
즉,
\[\text{Visual Cue} = \text{이미지에서 실제로 보이는 정보}\] \[\text{Pose Prior} = \text{학습된 인체 구조적 관계}\]입니다.
UDAPose는 이미지가 잘 보이는 관절에서는 visual cue를 더 활용하고, 잘 보이지 않는 관절에서는 pose prior를 더 활용하도록 만들고자 합니다.
1.5 논문의 핵심 Contributions
- UDAPose Framework
- Low-light annotation 없이 well-lit HPE dataset을 low-light domain으로 adaptation합니다.
- DHF + LCIM
- 실제 low-light reference에서 high-frequency detail을 보존하고 synthetic image에 주입합니다.
- DCA
- Transformer pose estimator에서 image cue와 pose prior의 contribution을 keypoint별로 동적으로 조절합니다.
- 실험적 검증
- ExLPose-test, ExLPose-OCN 및 cross-dataset EHPT-XC에서 기존 방법보다 높은 성능을 보입니다.
2. Related Work
2.1 Human Pose Estimation
기존 HPE는 크게 Top-down과 Bottom-up 방식으로 나뉩니다.
- Top-down: 사람을 먼저 detect한 뒤 각 사람의 pose를 예측
- Bottom-up: 전체 keypoint를 먼저 찾은 뒤 사람별로 grouping
최근에는 DETR 계열의 one-stage pose estimator가 등장하면서 human detection과 keypoint estimation을 하나의 architecture에서 처리하는 방향도 발전했습니다.
UDAPose의 pose estimator는 ED-Pose를 기반으로 합니다.
2.2 Low-Light Image Enhancement
Low-Light Image Enhancement(LLIE)는 어두운 이미지를 밝게 복원합니다.
하지만 극단적으로 어두운 이미지에서는 이미 사라진 detail을 완벽하게 복구하기 어렵고, enhancement artifact가 pose estimation 성능을 떨어뜨릴 수도 있습니다.
즉,
\[\text{Better-looking Image} \not\Rightarrow \text{Better Pose Estimation}\]일 수 있습니다.
2.3 Domain Adaptation & Image Translation
UDAPose와 가장 직접적으로 관련된 접근입니다.
핵심은 well-lit image의 pose annotation을 유지한 채 low-light domain으로 이미지만 변환하는 것입니다.
그러나 low-light domain adaptation에서는 단순한 color/style 변환을 넘어 실제 센서에서 나타나는 복잡한 degradation을 얼마나 잘 재현하는가가 중요합니다.
UDAPose는 이 문제를 frequency 관점에서 접근합니다.
3. Method
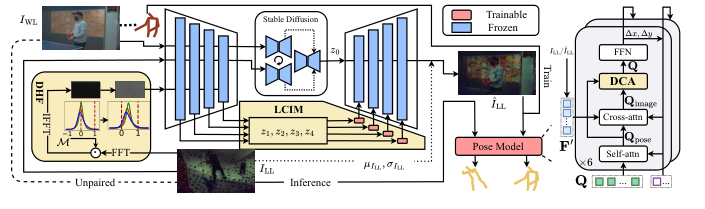
UDAPose의 Method는 크게 두 파트로 나눠서 이해하면 쉽습니다.
Part A. Low-Light Data Synthesis
\[I_{\text{WL}} + I_{\text{LL}} \rightarrow \hat{I}_{\text{LL}}\]- Stable Diffusion: scene structure + low-frequency appearance
- DHF: real low-light의 high-frequency detail 추출
- LCIM: 추출된 detail을 decoder에 주입
Part B. Low-Light Pose Estimation
\[\hat{I}_{\text{LL}} \rightarrow \text{Pose Estimator + DCA}\]- $Q_{\text{image}}$: image cue
- $Q_{\text{pose}}$: pose prior
- DCA: 두 feature의 비중을 동적으로 결정
3.1 Stable Diffusion 기반 Low-Light Synthesis
UDAPose는 pre-trained Stable Diffusion 2.1을 generative backbone으로 사용합니다.
Well-lit image $I_{\text{WL}}$의 scene structure와 reference low-light image $I_{\text{LL}}$의 low-frequency style을 포함하는 latent code $z_0$를 구성합니다.
개념적으로 보면,
\[z_0 \approx \text{Structure}(I_{\text{WL}}) + \text{Low-frequency Style}(I_{\text{LL}})\]입니다.
하지만 diffusion backbone만으로는 실제 low-light에서 나타나는 복잡한 high-frequency noise까지 충분히 보존하기 어렵습니다.
그래서 DHF와 LCIM이 추가됩니다.
3.2 DHF: Direct-Current-based High-Pass Filter
1. 목적
DHF의 목적은 real low-light reference에서 High-frequency Low-Light Characteristics를 추출하면서, 일반적인 high-pass filtering 과정에서 생기는 detail 손실을 막는 것입니다.
2. High-Pass Filtering
먼저 reference low-light image $I_{\text{LL}}$를 Fourier domain으로 변환한 뒤 high-pass filter $\mathcal{M}$을 적용합니다.
\[I_{\text{HP}} = \text{iFFT} \left( \text{FFT}(I_{\text{LL}}) \odot \mathcal{M} \right)\]- FFT: spatial domain → frequency domain
- $\mathcal{M}$: high-pass filter
- iFFT: frequency domain → spatial domain
$I_{\text{HP}}$는 평균이 거의 0이며, pixel 값은 주변 평균에 대한 밝고 어두운 deviation을 나타냅니다.
3. 단순 High-Pass Filter의 문제
High-pass filtering 결과에는 음수 값이 포함될 수 있습니다.
예를 들어,
\[[-0.12,\; 0.04,\; 0.10,\; -0.05]\]와 같은 값입니다.
하지만 Stable Diffusion encoder에 넣으려면 일반적으로 RGB의 정상 범위로 맞춰야 합니다.
이때 단순 clipping을 하면,
\[-0.12 \rightarrow 0\]처럼 negative high-frequency detail이 사라집니다.
특히 low-light에서는 어두운 방향의 작은 intensity variation 역시 중요한 정보이므로 이 손실이 문제가 됩니다.
4. DHF의 해결 방법
저자들은 high-frequency image의 평균을 원본 low-light reference의 평균으로 이동시킵니다.
\[I_{\text{DHF}} = I_{\text{HP}} + \left( \text{mean}(I_{\text{LL}}) - \text{mean}(I_{\text{HP}}) \right)\]따라서,
\[\text{mean}(I_{\text{DHF}}) = \text{mean}(I_{\text{LL}})\]가 됩니다.
쉽게 말하면,
High-frequency detail의 모양은 유지하면서 전체 분포를 위로 이동시켜 clipping으로 dark detail이 사라지는 것을 줄이는 방식
입니다.
DHF 한 줄 요약
실제 low-light의 fine detail/noise를 뽑되, 음수 영역이 clipping으로 사라지지 않도록 DC 성분을 이용해 다시 중심을 맞춘다.
3.3 LCIM: Low-Light Characteristics Injection Module
DHF는 low-light의 high-frequency 정보를 추출하는 단계입니다.
하지만 추출된 정보를 실제 synthetic image에 넣어야 합니다.
그 역할을 하는 것이 LCIM입니다.
1. Multi-scale Feature 추출
DHF 결과 $I_{\text{DHF}}$에서 서로 다른 scale의 intermediate feature를 얻습니다.
\[\{z_1, z_2, z_3, z_4\}\]각 feature를 lightweight convolution layer로 처리합니다.
\[\{f_1,f_2,f_3,f_4\} = \text{LCIM} ( \{z_1,z_2,z_3,z_4\} )\]2. 왜 Multi-scale인가?
Low-light degradation은 한 가지 scale에서만 발생하지 않습니다.
예를 들면,
- 작은 scale: pixel-level noise
- 중간 scale: local texture 변화
- 큰 scale: spatially varying illumination/degradation
처럼 다양한 수준의 정보가 존재할 수 있습니다.
따라서 LCIM은 하나의 feature만 마지막에 넣는 것이 아니라 VAE decoder의 여러 resolution 단계에 low-light feature를 주입합니다.
3. Decoder에 Feature Injection
Stable Diffusion의 VAE decoder를 $d_1,\dots,d_4$와 최종 convolution $d_{\text{final}}$로 두면,
\[\hat{I}'_{\text{LL}} = d_{\text{final}} ( d_4( d_3( d_2( d_1(z_0)+f_1 )+f_2 )+f_3 )+f_4 )\]와 같이 각 block의 output에 high-frequency feature를 더합니다.
즉,
Stable Diffusion이 전체적인 구조와 appearance를 생성하는 동안, LCIM이 각 scale에서 실제 low-light의 세밀한 특성을 계속 주입하는 구조
입니다.
4. 마지막 Global Style Matching
LCIM을 거친 이미지 $\hat{I}’{\text{LL}}$에 대해 reference $I{\text{LL}}$의 channel-wise mean과 standard deviation을 맞춰 최종 synthetic image $\hat{I}_{\text{LL}}$을 만듭니다.
따라서 UDAPose는 크게
- Low-frequency/global appearance
- High-frequency/fine detail
두 요소를 모두 맞추려고 합니다.
3.4 LCIM Training Loss
LCIM은 spatial domain뿐만 아니라 frequency domain에서도 reconstruction을 잘하도록 학습됩니다.
전체 loss는
\[\mathcal{L}_{\mathcal{D}} = \mathcal{L}_{\text{MSE}} + \lambda \mathcal{L}_{\text{freq}}\]입니다.
1. MSE Loss
\[\mathcal{L}_{\text{MSE}}(I,\hat{I})\]pixel-level reconstruction을 통해 기본적인 content fidelity를 유지합니다.
2. Frequency Loss
\[\mathcal{L}_{\text{freq}} = \frac{1}{MN} \sum_{u=0}^{M-1} \sum_{v=0}^{N-1} \mathcal{W}(u,v) \left| \mathcal{F}_{I}(u,v) - \mathcal{F}_{\hat{I}}(u,v) \right|^2\]여기서 $\mathcal{F}$는 Fourier magnitude spectrum입니다.
Weight는 다음과 같습니다.
\[\mathcal{W}(u,v) = \sin \left( \frac{\pi |2u-M|}{2M} \right) + \sin \left( \frac{\pi |2v-N|}{2N} \right)\]이 weighting은 mid-to-high frequency component를 더 중요하게 반영하기 위해 사용됩니다.
즉, 단순히 pixel 모양만 비슷하게 복원하는 것이 아니라,
“실제 low-light가 가진 frequency 특성까지 비슷하게 만들어라.”
라고 학습시키는 것입니다.
3.5 DCA: Dynamic Control of Attention
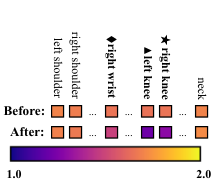
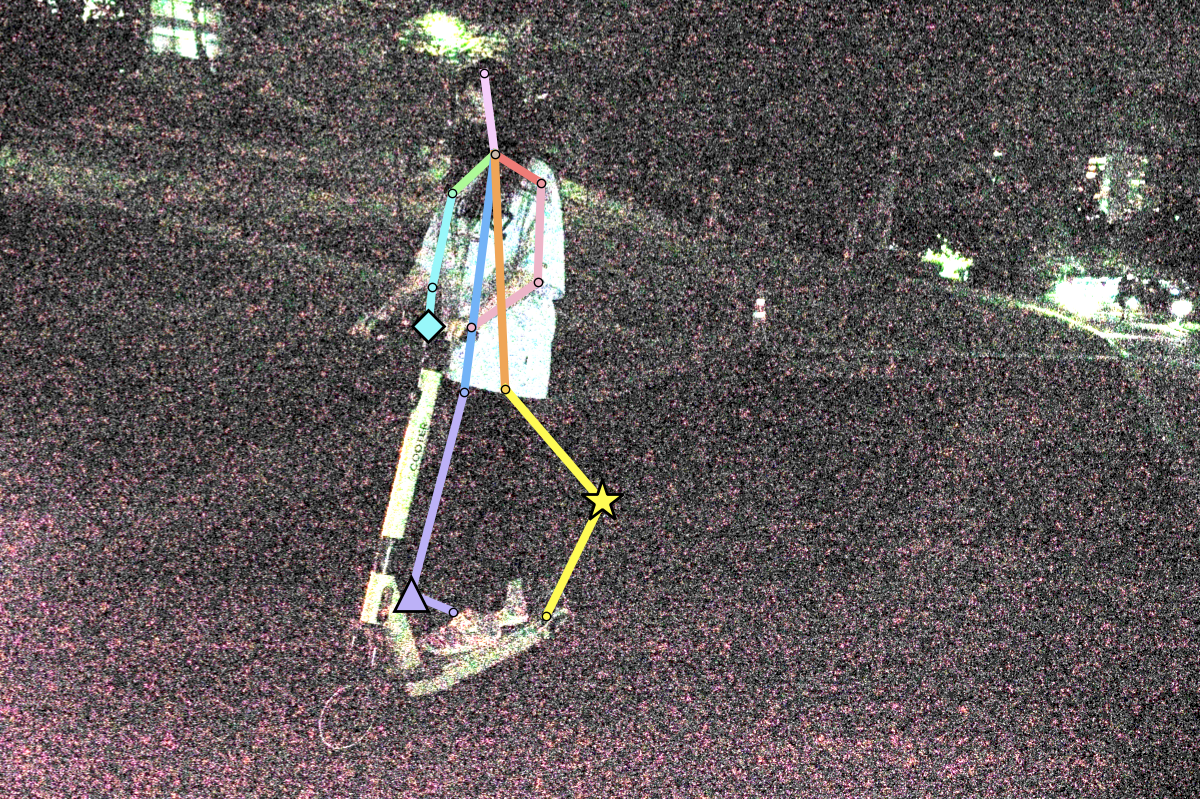
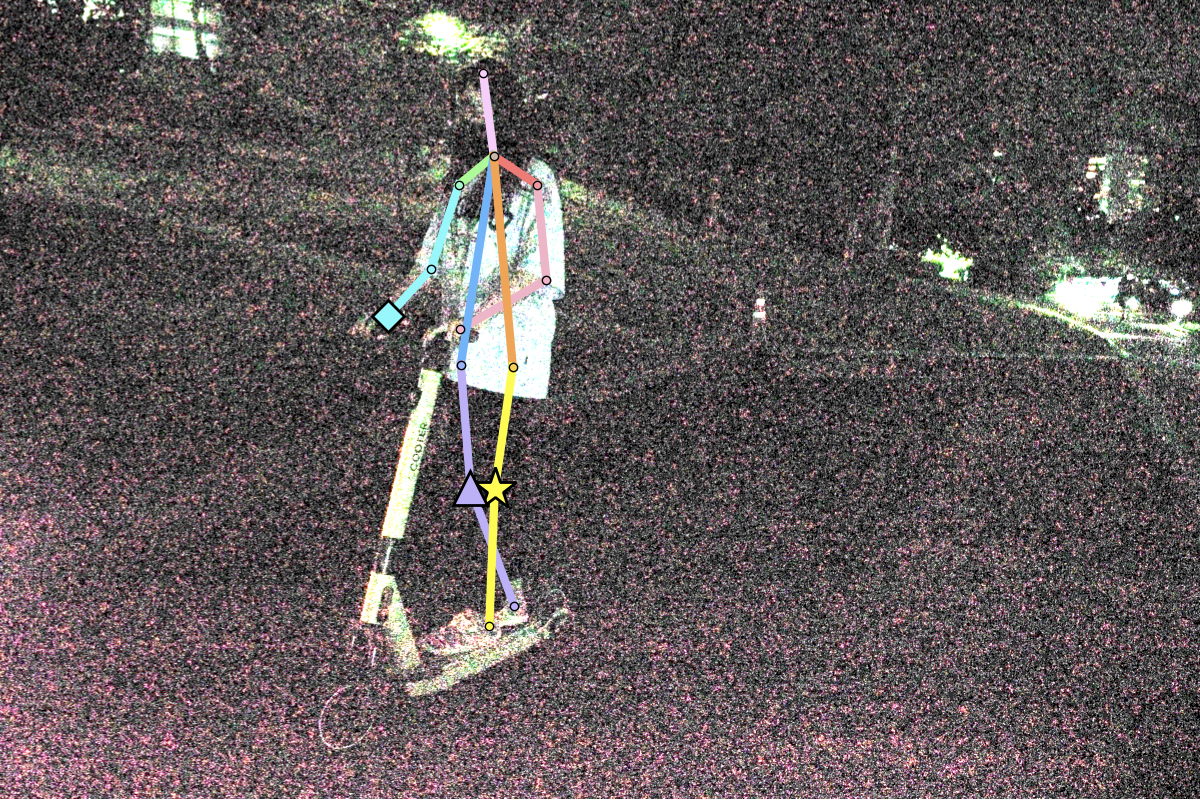
Figure 4: DCA 적용 전후 Image Cue / Pose Prior 비중 및 pose prediction 비교
DHF와 LCIM이 Training Data 문제를 해결한다면, DCA는 Pose Estimator 자체의 robustness 문제를 해결합니다.
1. 두 종류의 정보
Transformer pose estimator 내부에는 크게 두 정보가 존재합니다.
$Q_{\text{image}}$: Visual Cue
Deformable cross-attention을 통해 이미지 feature에서 가져오는 정보입니다.
쉽게 말하면,
“실제 이미지상에서 이 관절이 어디에 보이는가?”
에 대한 정보입니다.
$Q_{\text{pose}}$: Pose Prior
Keypoint latent끼리 self-attention을 수행해 얻는 구조적 정보입니다.
쉽게 말하면,
“다른 관절들의 위치를 고려했을 때 이 관절은 어디에 있을 가능성이 높은가?”
에 대한 정보입니다.
2. 기존 방식의 문제
기존 DETR 기반 pose estimator는 두 representation을 직접 더하는 rigid fusion을 사용합니다.
문제는 image cue가 매우 불확실한 low-light에서도 image feature의 영향력이 충분히 줄어들지 않는다는 점입니다.
논문에서는 잘 보이지 않는 knee에서도
\[\frac{\|Q_{\text{image}}\|_2}{\|Q_{\text{pose}}\|_2} \approx 1.7\]정도의 높은 비율이 유지되는 사례를 제시합니다.
즉,
안 보이는 관절에서도 모델이 image cue를 계속 강하게 신뢰하는 것
이 문제입니다.
3. DCA의 핵심 아이디어
먼저 두 feature를 concatenate합니다.
\[Q_{\text{cat}} = \text{Concat} ( Q_{\text{pose}}, Q_{\text{image}} )\]그 뒤 2-layer MLP와 softmax를 이용하여 두 weight를 얻습니다.
\[(w_{\text{pose}},w_{\text{image}}) = \text{softmax} ( \text{MLP}(Q_{\text{cat}}) )\]마지막으로,
\[Q = w_{\text{pose}} \odot Q_{\text{pose}} + w_{\text{image}} \odot Q_{\text{image}}\]로 두 정보를 결합합니다.
4. 핵심은 Keypoint별 Dynamic Weight
DCA는 이미지 전체에 하나의 weight를 적용하는 것이 아니라 각 keypoint별로 다른 weight를 학습할 수 있습니다.
예를 들어,
- shoulder가 잘 보임 → $w_{\text{image}}$ 증가
- ankle이 거의 보이지 않음 → $w_{\text{pose}}$ 증가
와 같이 동작할 수 있습니다.
즉 DCA의 철학은 한 문장으로 정리할 수 있습니다.
“눈에 잘 보이면 이미지를 믿고, 잘 안 보이면 사람 몸의 구조적 prior를 더 믿자.”
3.6 Pose Estimation Training
UDAPose의 pose estimator는 ED-Pose를 기반으로 합니다.
Pose model은 synthetic low-light image $\hat{I}_{\text{LL}}$와 well-lit image에서 상속받은 pose annotation을 이용해 supervised training됩니다.
Loss는 ED-Pose의 set-based Hungarian matching 방식을 따르며,
- Classification loss $\mathcal{L}_c$
- Human bounding box regression loss $\mathcal{L}_h$
- Keypoint regression loss $\mathcal{L}_k$
의 weighted sum으로 구성됩니다.
Keypoint regression은 L1 loss와 OKS(Object Keypoint Similarity) 기반 loss를 사용합니다.
✔️ Method 핵심 Q&A
Q. Stable Diffusion은 무엇을 담당하는가?
Well-lit image의 scene structure와 reference low-light image의 global/low-frequency appearance를 결합합니다.
Q. DHF는 무엇을 담당하는가?
Real low-light image에서 high-frequency characteristic을 보존해서 추출합니다.
Q. LCIM은 무엇을 담당하는가?
DHF가 추출한 low-light feature를 VAE decoder 여러 scale에 주입합니다.
Q. DCA는 무엇을 담당하는가?
Pose estimator에서 visual cue와 learned pose prior 중 무엇을 얼마나 믿을지를 keypoint별로 동적으로 결정합니다.
Q. 세 모듈을 한 문장으로 요약하면?
DHF + LCIM은 “진짜 저조도에 가까운 학습 데이터를 만들기 위한 장치”, DCA는 “저조도에서 잘못된 visual cue를 덜 믿게 만드는 장치”입니다.
4. Experimental Evaluation
4.1 Dataset
논문은 주로 다음 dataset을 사용합니다.
ExLPose-test
- 총 491장의 optically filtered image
- 밝기를 약 100배 감소
- 난이도에 따라 세 subset으로 분리
- LL-N: Low-Light Normal
- LL-H: Low-Light Hard
- LL-E: Low-Light Extreme
전체 low-light set은 LL-A라고 부릅니다.
ExLPose-OCN
- 실제 야간 환경에서 촬영된 real low-light image
- 총 360장
- A7M3 / RICOH3 카메라 사용
EHPT-XC
- RGB + Event 기반 HPE/Tracking dataset
- low-light뿐 아니라 motion blur 등 challenging condition 포함
- 논문에서는 그중 low-light condition의 12 scene, 1,200장을 선택해 cross-dataset evaluation 수행
4.2 ExLPose-test 결과
| Method | WL | LL-A | LL-N | LL-H | LL-E |
|---|---|---|---|---|---|
| RFormer | 60.0 | 4.5 | 15.2 | 0.3 | 0.8 |
| QuadPrior | 60.2 | 8.9 | 19.3 | 4.6 | 0.3 |
| CycleGAN | 61.3 | 19.6 | 33.7 | 17.9 | 3.3 |
| ELLA | 61.5 | 18.6 | 32.3 | 17.2 | 3.4 |
| UDAPose | 67.3 | 27.0 | 38.7 | 28.0 | 11.7 |
특히 LL-H에서 기존 최고 성능인 CycleGAN의 17.9 AP보다 10.1 AP 높은 28.0 AP를 기록했습니다.
LL-E에서는 ELLA의 3.4 AP 대비 11.7 AP로 세 배 이상 높은 성능을 보였습니다.
즉, 저조도가 심해질수록 UDAPose의 장점이 더 커집니다.
4.3 ExLPose-OCN 결과
실제 야간 촬영 이미지에서도 UDAPose가 가장 높은 성능을 기록했습니다.
| Method | Avg. AP | A7M3 AP | RICOH3 AP |
|---|---|---|---|
| CycleGAN | 45.1 | 47.5 | 42.7 |
| ELLA | 46.0 | 48.5 | 43.5 |
| UDAPose | 51.4 | 55.0 | 47.9 |
이는 synthetic low-light에서만 좋은 것이 아니라 real-world low-light에서도 개선이 유지됨을 보여주는 중요한 결과입니다.
4.4 Cross-Dataset Evaluation: EHPT-XC
UDAPose는 ExLPose에서 학습한 모델을 별도 fine-tuning 없이 EHPT-XC에 평가했습니다.
| Method | AP@0.5:0.95 |
|---|---|
| CycleGAN | 20.7 |
| EnCo | 18.3 |
| ELLA | 23.6 |
| UDAPose | 31.0 |
가장 강한 baseline인 ELLA보다 +7.4 AP 높습니다.
이 실험의 의미는 다음과 같습니다.
UDAPose가 특정 ExLPose의 저조도 특성만 외운 것이 아니라, unseen low-light domain에서도 어느 정도 generalize한다.
4.5 Ablation Study
각 component가 실제로 얼마나 기여하는지 확인한 결과입니다.
| Configuration | LL-N | LL-H | LL-E | EHPT-XC |
|---|---|---|---|---|
| Well-lit only | 3.4 | 0.4 | 0.2 | 0.3 |
| Histogram Matching | 21.3 | 1.3 | 0.5 | 1.5 |
| Baseline SD | 23.7 | 7.2 | 0.0 | 3.2 |
| + AIN | 25.2 | 8.8 | 2.4 | 6.1 |
| + LCIM | 31.5 | 20.7 | 7.8 | 19.5 |
| + DHF | 35.3 | 25.3 | 9.4 | 24.4 |
| + DCA | 38.7 | 28.0 | 11.7 | 31.0 |
가장 중요한 해석
1. 단순 밝기 변환만으로는 부족하다
Histogram Matching은 LL-N에서는 어느 정도 개선되지만 LL-H와 LL-E에서 거의 성능을 내지 못합니다.
→ 단순한 global brightness/color distribution matching으로 real low-light domain을 충분히 표현하기 어렵다는 의미입니다.
2. LCIM의 효과가 매우 크다
Baseline SD에서 LCIM을 추가하면,
- LL-H: 7.2 → 20.7
- LL-E: 0.0 → 7.8
- EHPT-XC: 3.2 → 19.5
로 크게 상승합니다.
즉, reference low-light image의 high-frequency characteristic을 실제 synthetic data에 주입하는 것이 핵심적인 contribution임을 보여줍니다.
3. DHF 역시 추가 개선
DHF 추가 후,
- LL-H: +4.6 AP
- LL-E: +1.6 AP
개선됩니다.
High-frequency detail을 clipping 손실 없이 보존하는 것이 실제 성능에 도움이 된다는 근거입니다.
4. DCA는 Pose Estimator 측면에서 추가 개선
DCA를 추가하면,
- LL-N: +3.4 AP
- LL-H: +2.7 AP
- LL-E: +2.3 AP
- EHPT-XC: +6.6 AP
가 개선됩니다.
즉, 데이터 합성뿐만 아니라 pose estimator 내부에서 unreliable visual cue를 다루는 방식 역시 중요합니다.
4.6 Source Dataset을 키우면 어떻게 되는가?
UDAPose는 source well-lit dataset으로 특정 dataset만 요구하지 않습니다.
논문에서는 약 2k 규모의 ExLPose well-lit source 대신 약 12k 규모의 CrowdPose를 사용했을 때 성능이 추가로 크게 향상되었습니다.
특히 EHPT-XC에서
\[31.0 \rightarrow 45.7 \text{ AP}\]로 증가했습니다.
즉,
well-lit pose label은 많이 확보하고, low-light 쪽에서는 unlabeled reference만 확보해도 adaptation을 확장할 수 있다
는 것이 UDAPose의 실용적인 장점입니다.
5. Discussion & Limitation
5.1 Low-Light에 특화된 Framework
현재 DHF, LCIM, DCA는 insufficient illumination에서 발생하는 degradation을 중심으로 설계되어 있습니다.
따라서 다음과 같은 다른 degradation까지 자동으로 해결한다고 볼 수는 없습니다.
- Dense fog
- Heavy rain
- Severe motion blur
저자들도 향후 이러한 low-visibility condition으로 generative adaptation을 확장하는 것을 future work로 제시합니다.
5.2 Stable Diffusion의 계산 비용
Low-light synthetic training dataset을 생성하기 위해 대형 diffusion model을 사용하기 때문에 상당한 GPU memory와 시간이 필요합니다.
즉,
annotation 비용은 줄지만 synthetic data generation 비용은 증가한다
는 trade-off가 있습니다.
저자들은 향후 consistency model이나 distilled diffusion model과 같이 더 효율적인 generator를 사용하는 방향을 제안합니다.
5.3 완전한 Real-Capture Modeling이라고 볼 수는 없다
UDAPose는 real low-light reference의 특징을 기존 augmentation보다 더 정교하게 전달하지만, 결국 synthetic image generation pipeline입니다.
따라서 특정 카메라의 full ISP pipeline, exposure parameter, motion-induced blur 등 모든 실제 촬영 과정을 물리적으로 그대로 재현하는 것은 아닙니다.
특히 noise 외의 capture-dependent degradation을 연구하려면 별도의 real-capture validation이 여전히 중요합니다.
7. 최종 정리
UDAPose에서 기억해야 할 핵심은 세 가지입니다.
1. Synthetic Low-Light의 현실성
단순 brightness/noise augmentation만으로는 실제 low-light를 충분히 표현하기 어렵습니다.
→ DHF + LCIM
2. Low-Light에서 Image Cue는 항상 신뢰할 수 없다
관절이 거의 보이지 않는데도 visual cue를 강하게 사용하는 것은 pose estimation 오류로 이어집니다.
→ DCA
3. Low-Light Annotation 없이도 Adaptation 가능
Well-lit pose annotation과 unlabeled real low-light reference만으로 low-light training data를 생성합니다.
UDAPose를 한 문장으로 요약한다면
“실제 저조도 이미지의 세밀한 특성을 well-lit pose dataset에 주입해 현실적인 low-light training data를 만들고, 관절이 잘 안 보일 때는 image cue 대신 learned pose prior를 더 활용하도록 동적으로 조절하는 Low-Light HPE Domain Adaptation Framework.”